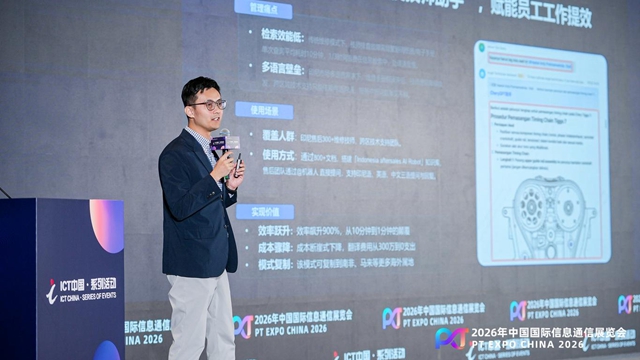





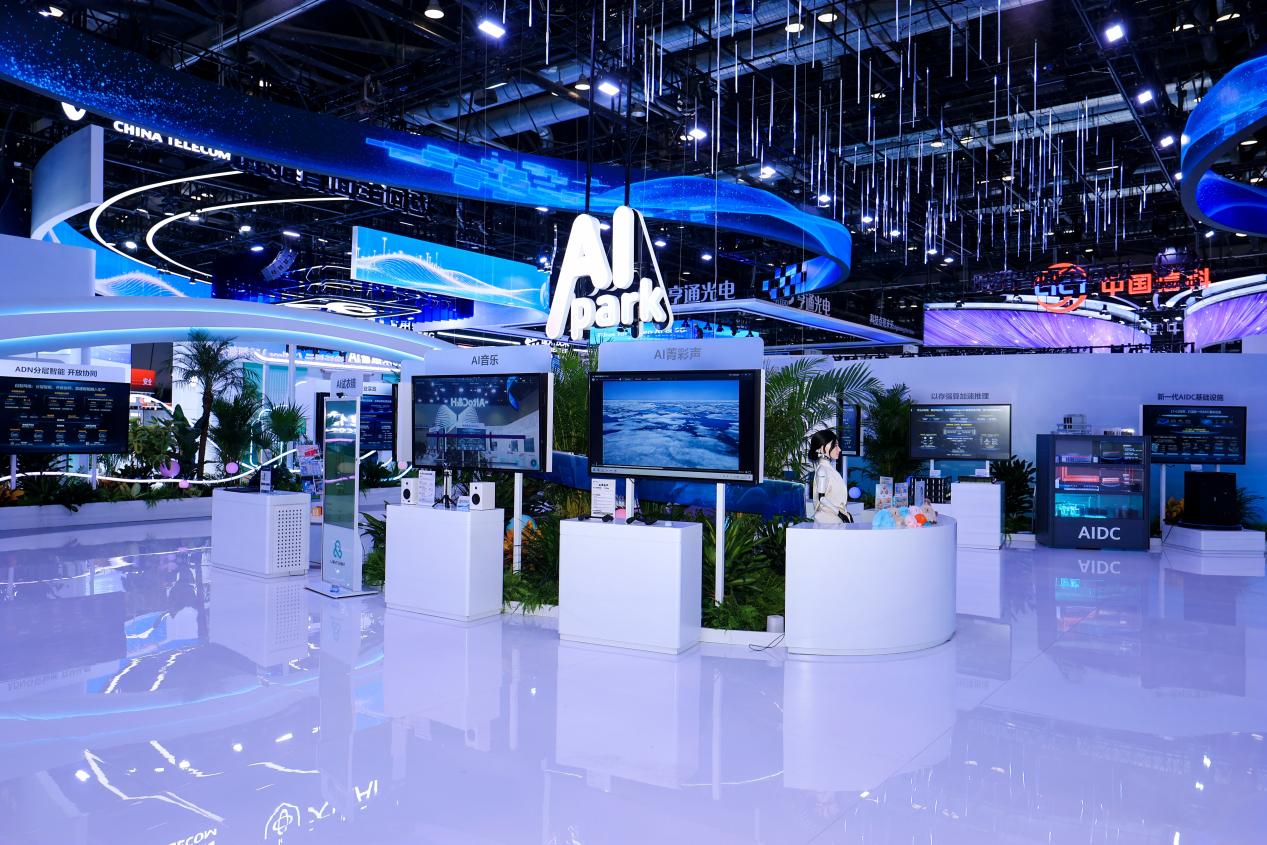
9月22日,2026年中国国际信息通信展览会(PT展)在北京国家会议中心举行。马栏山音视频实验室携国产三维沉浸声技术——Audio Vivid菁彩声亮相华为AIpark展台,通过"HDR Vivid+ Audio Vivid菁彩视听"沉浸体验、云端AI 2D转3D实时演示等形式,向业界展示中国自主音视频标准的产业化落地能力。
标准自主:全球首个基于AI的三维沉浸声编解码标准
菁彩声(Audio Vivid)是中国自主研发、全球首个基于AI的三维沉浸声(空间音频)编解码标准,由UWA联盟与AVS联合制定,中央广播电视总台牵头研制,华为、马栏山音视频实验室深度参与。它让声音在三维空间里精确定位、自由移动,带来"声临其境"的沉浸听感,是我国音视频领域实现技术自主可控的关键一环。
同一段影片,两个版本:把"听得见"变成"听得好"
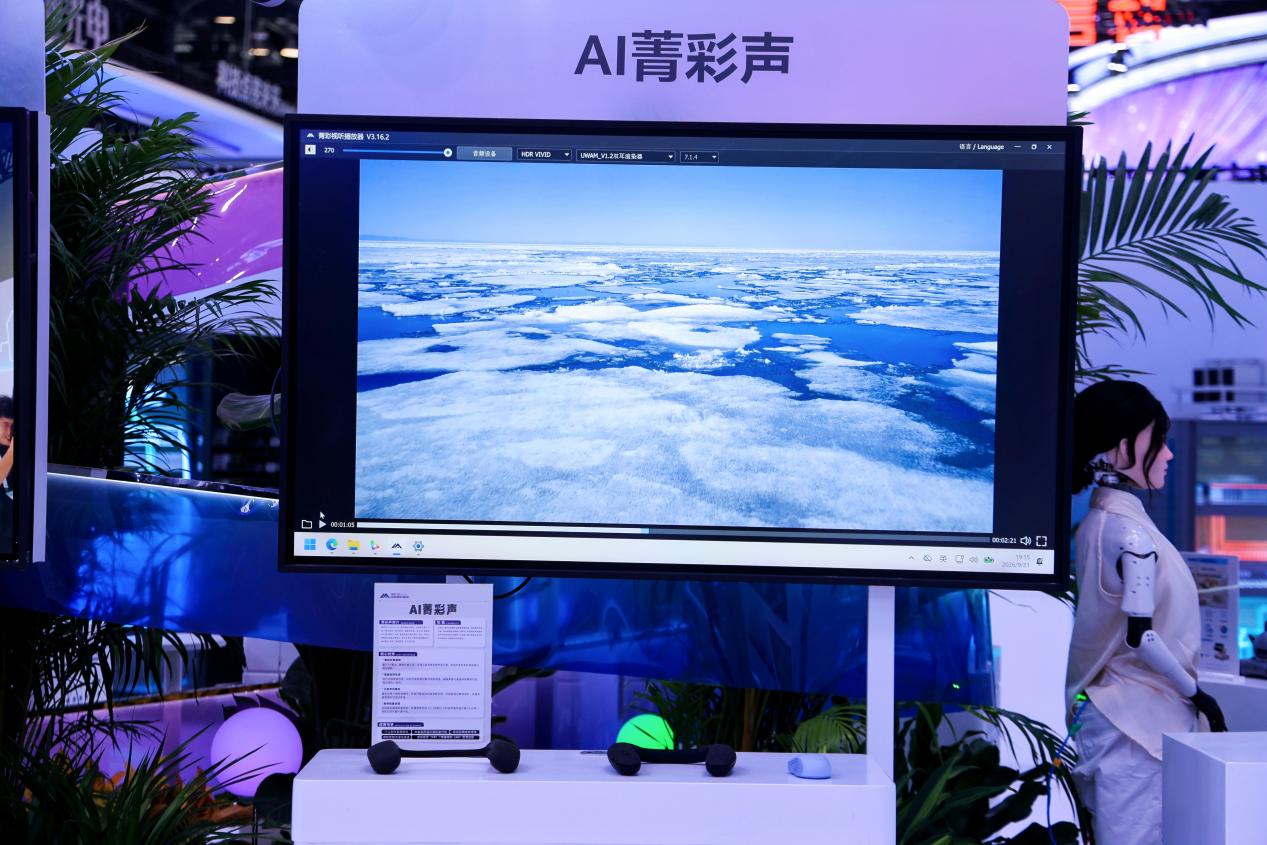
在AI菁彩声体验区,参观者可佩戴颈挂式音箱,观看同一段影片的两个配音版本:一版为传统SDR+立体声,一版为HDR Vivid+ Audio Vivid菁彩声。声音的差别来自声音对象的定位方式。传统立体声只有左右两个平面声道,声音被"压"在一条线上;而菁彩声让声音在三维空间中精确定位、自由移动——轻风从头顶掠过,雨滴落在身后,人声从正前方逼近,方位、距离与运动轨迹都清晰可辨,环境音效的包裹感显著增强。同时HDR Vivid让视频画面同样"升级",如果说菁彩声提升的是"听",那么HDR Vivid(菁彩影像)提升的则是"看"。两者同属"菁彩 Vivid"技术家族——菁彩声管听觉,菁彩影像管视觉,合称"菁彩视听",共同构成本次展出"看得清楚、听得沉浸"的完整体验。
云端2D转3D:让存量双声道内容"一键空间化"
本次展示的另一重点,是马栏山音视频实验室自研的AI菁彩声转制工具,可实现海量存量内容的音频2D转3D能力。其技术路径分为三步:第一步,以AI算法深度解析双声道音频数据,精准分离人声、交通工具声、环境声等声音对象,实现高保真识别与提取;第二步,结合视频画面信息,自动生成声音对象的动态轨迹,确保声音与画面场景精准匹配,强化视听一致性;第三步,重建三维声场,真实还原空间细节,构建身临其境的沉浸式声场。目前通过服务器端批量进行音频2D到3D的转制,处理效率达2:1——转制1小时双声道内容仅需30分钟,可轻松完成存量片源的规模化升级。
AI菁彩声目前主要面向五类应用:个人创作音频优化、存量双声道片源批量升级、影视后期音效增强、游戏音频沉浸化改造,以及虚拟现实(VR)/增强现实(AR)音频适配。
马栏山音视频实验室已构建基于双Vivid标准的音视频"采、编、播、传、显"全链条科技创新体系,聚焦音视频技术研究、音视频AI技术赋能、音视频产品创新与音视频产业生态发展四大方向,持续完善产业生态,开展测试验证,孵化创新应用场景,支撑建设具有核心竞争力的双Vivid音视频产业集群。