




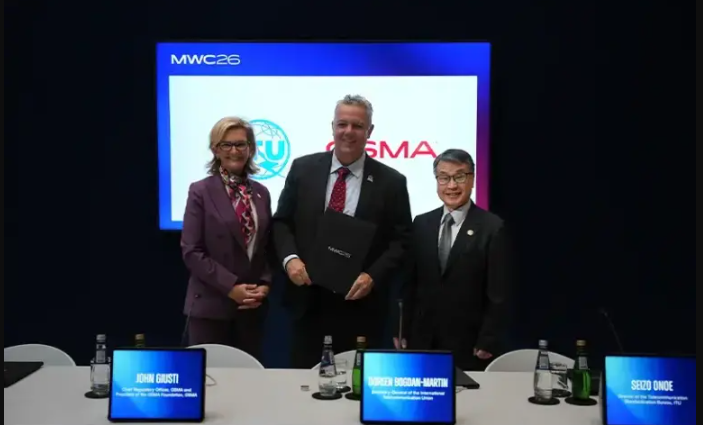
C114讯 11月17日消息(岳明)在近日举办的MWC26多哈大会期间,GSMA与国际电信联盟(ITU)签署了一份意向书,将围绕GSMA的“开放电信人工智能”(Open Telco AI)计划,在“可信、开放的电信AI”领域展开合作。
其核心理念在于,运营商不应在AI能力上过度依赖少数几家大型供应商,尤其是在容错率极低、出错代价高昂的网络领域。
意向书涵盖的内容
意向书的效力低于谅解备忘录(MOU),不承载任何约束性义务或争端解决机制。这份意向书为Open Telco AI合作设定了一个框架——该计划由GSMA主导,致力于开发电信领域的模型、数据及基准测试。
合作分为三个工作方向:第一个方向涵盖面向网络运营、基础设施和标准的电信级AI;第二个方向涉及电信行业专有的数据资产;第三个方向则涵盖“OTel”开放模型系列的训练、部署与评估。双方还计划在技术标准、开放数据互操作性以及评估框架方面实现协同。目标是“在全球网络上实现安全、透明、高精度的AI”。
目前,双方尚未披露资金来源、人员配置、截止期限、治理结构或许可条款等信息。GSMA首席监管官John Giusti代表GSMA签署了文件。ITU电信标准化局主任Seizo Onoe也出现在了签署现场。ITU电信标准化局将负责相关的标准制定工作。
运营商为何需要开放的电信模型
来自AT&T的Mark Austin指出,通用AI模型在回答电信标准相关问题时,准确率仅在60%-70%左右;GSMA的Louis Powell则表示,模型在数学和编程能力上的提升,并不能直接转化为在电信任务中的出色表现。 AT&T表示,其针对电信领域训练的模型在同类基准测试中准确率可达90%左右——不过这是厂商自己报告的数字。
GSMA表示,在通用能力测试中表现亮眼的大模型,一旦面对真实的电信场景,往往力不从心。因为这些通用AI模型在设计之初并未充分考虑电信行业的需求,若让通用模型去解读行业标准或排查现网故障,其局限性便会显现——这并非因为模型本身能力不足,而是因为它们所学习的训练数据几乎未涵盖电信领域。
目前,其中最受关注的Open Telco AI模型之一是AT&T推出的OTel 2.0。它基于Gemma 4 31B-IT,利用4000亿个电信专用Token进行后续训练而成。GSMA在今年7月表示,OTel 2.0在Open Telco AI排行榜上居首。该组织表示,OTel 2.0模型的下载量从5月的1600万次增至7月下旬的超1800万次,到10月已超3000万次。
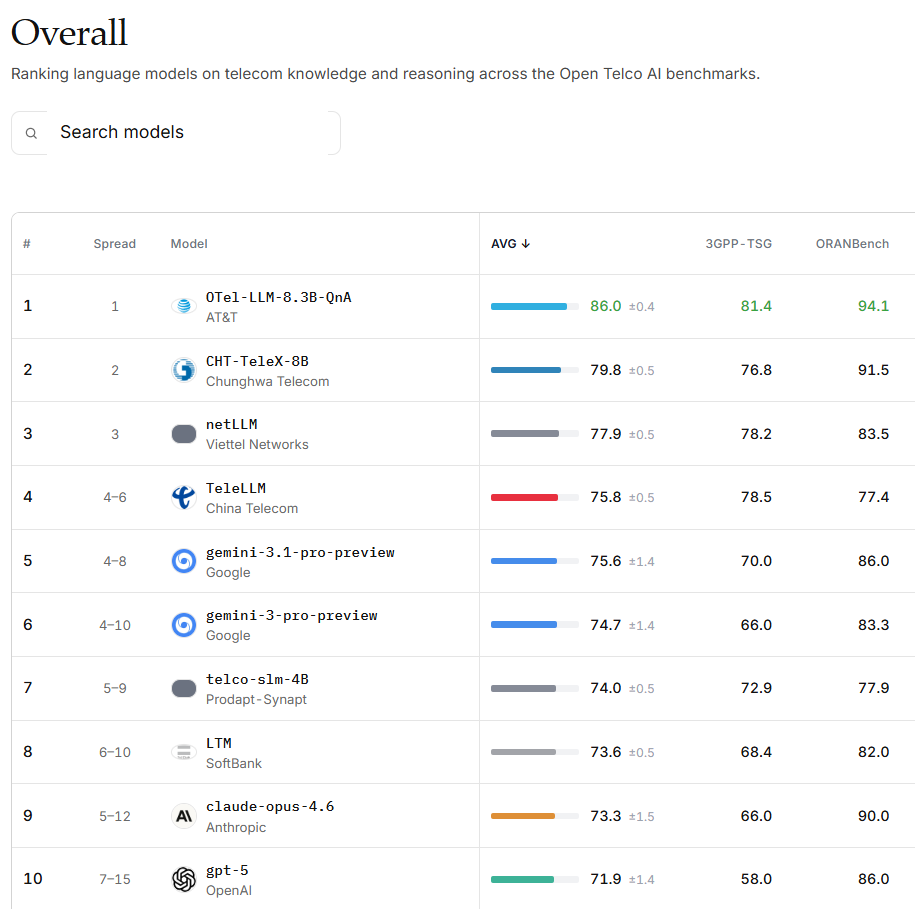
图:Hugging Face网站上关于Open Telco AI的模型排行榜。
下载量并不等同于实际部署价值。据GSMA智库(GSMA Intelligence)估算,AI对运营商营收的贡献率约为2.5%;在具体部署目标中,62%侧重于成本节约,38%侧重于创收。在电信行业的生成式AI部署中,仅有约16%是针对网络运营场景的。
在GSMA的Louis Powell看来,这意味着开放性已成为一个供应链问题。他指出,电信行业的核心AI技术由四五家大厂掌握,一旦其中某家供应商切断服务,运营商便会陷入被动。而若运营商拥有经过自身微调的模型,则能更好地掌控业务连续性,并在安全护栏上保留更多控制权。
关于Open Telco AI的阶段性成果
据C114了解,GSMA在今年7月左右发布了关于推动Open Telco AI工作的阶段性成果报告。
参与Open Telco AI的运营商包括AT&T、德国电信(Deutsche Telekom)、Orange、西班牙电信(Telefónica)、沃达丰(Vodafone)、Liberty Global、KPN、瑞士电信(Swisscom)、中国电信、KDDI、du、Turkcell等,参与的技术与研究机构则包括英伟达、Hugging Face、Linux基金会、华为GTS等。
截至2026年7月,该项目已完成两个阶段的迭代。第一阶段聚焦于通用电信知识的考察,验证模型对3GPP 标准、O-RAN规范等基础文档的掌握程度。第二阶段显著拓展了评测深度,将重点转向网络管理、配置和故障排查等真实工作场景,更接近运营商日常运维的实际需求。
评测体系的核心产出是Open Telco数据集,基于Inspect AI框架构建。基于这一评测体系,当时GSMA对86个模型进行了系统评测,并将结果以开放排行榜的形式对外发布。
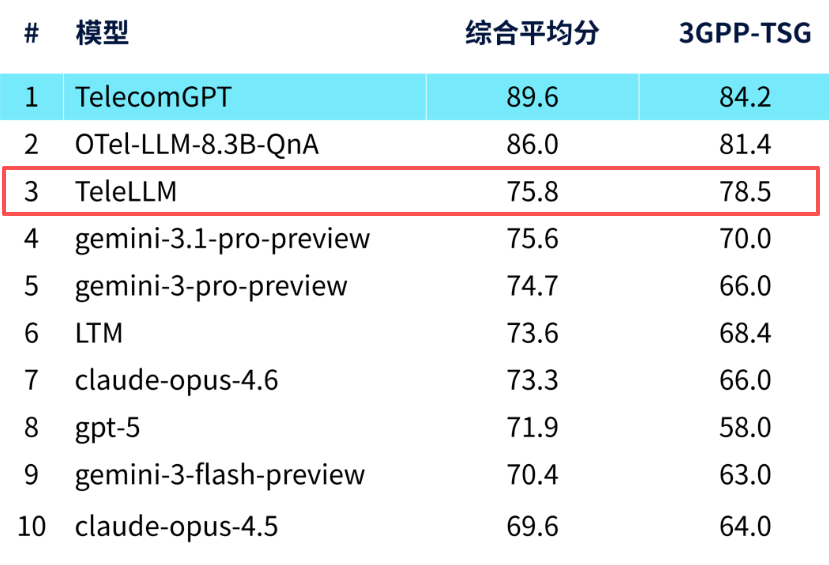
资料来源:GSMA。
在 7月公布的评测结果中,中国电信TeleLLM模型跻身第3(75.8分),成为中国挤入前三的运营商自研模型。
GSMA方面表示,由于电信业没有类似“维基百科”的资源,行业不得不从零开始构建训练数据。
最初的数据集包含约150亿个Token,由GSMA提供。该数据集通过收集并处理来自七个标准制定组织(3GPP、ETSI、GSMA、CAMARA、ITU、O-RAN和TM Forum)的文档,将各类密集的技术规范转化为适合模型训练的素材。此外,GSMA与Pleias还发布了电信语料库(Telco Corpus)——GSMA表示,这是截至目前为电信业构建的规模最大的预训练数据集,包含约100亿个Token。
随后,该数据集与来自AT&T的额外数据相结合(在Red Hat、戴尔、微软Azure和AMD的协作下),最终构建出包含4000亿个Token的训练数据集。由此产出的成果,便是OTel 2.0系列的首个版本。
ITU在自身AI议题讨论中的角色
ITU此前已深度参与电信领域AI方面的相关工作。
例如,ITU在其“人工智能造福人类”(AI for Good)平台上举办了“电信人工智能故障排查挑战赛”(AI Telco Troubleshooting Challenge);同时,它还是TelcoRetrieve项目的合作伙伴,该项目旨在测试模型能否基于电信标准给出准确回答;此外,它还参与了AI Agents for RAN项目,该项目旨在测试无线接入网模拟器中的自动化智能体。
两项挑战赛均由GSMA、ETSI、IEEE、ITU与华为共同发起。此前举办的故障排查挑战赛吸引了来自104个国家的1255名参赛者。
因此,这份意向书旨在将既有合作关系正式化,而非从零新建一个项目。它与ITU的“基于开放电信智能体的智能”(Open Telecom Agent-Based Intelligence,简称OTAI)倡议并行推进,但两者相互独立;OTAI主要关注AI智能体之间的互操作性。
不过,其中的政治因素难以忽视。
在ITU全权代表大会(PP-26)上,各成员国正在修订第214号决议——即ITU关于AI的授权文件。美国的一项提案主张将“人工智能”(artificial intelligence)替换为“超级智能”(super intelligence),并禁止ITU在政策、治理或伦理框架方面提供支持。
至于GSMA关于Open Telco AI的下一步计划,是把评测从“能不能答对题目”扩展到“能不能真正操作网络”。让AI智能体进入真实的网络拓扑中去配置、诊断、优化,接受更接近生产环境的考验。能效、延迟、首Token响应时间等工程指标,也将纳入评测维度。