




人类婴儿学会抓握一个杯子,是无数次“拿不稳、摔了、再来”的真实物理反馈。今天的机器人恰恰相反:学习了上万段抓握视频,在仿真环境里行云流水,走进真实世界就频繁“手滑”。
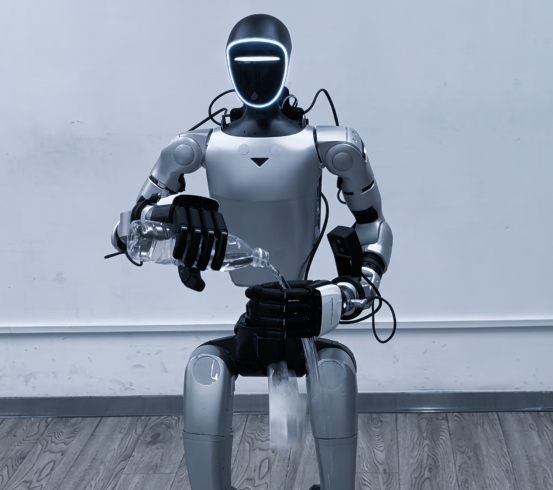
美梦空间测试机器人的物理理解力
整个行业都在追问:到底是什么困住了具身智能的大规模落地?真相就是,在物理世界面前,几乎所有机器人都在“裸考”。
9月24日,第五届全球数字贸易博览会上,杭州美梦空间科技有限公司(Memo)给具身智能补上了这堂“物理课”。教具是两份:全球首个具备物理感知能力的Physical-WAM物理-世界动作模型,以及业内首个RoboTwin-phys物理漂移评测基准——一个负责让机器人“懂物理”,具备人类式的预判能力,一个验证它是否真的“懂了”。
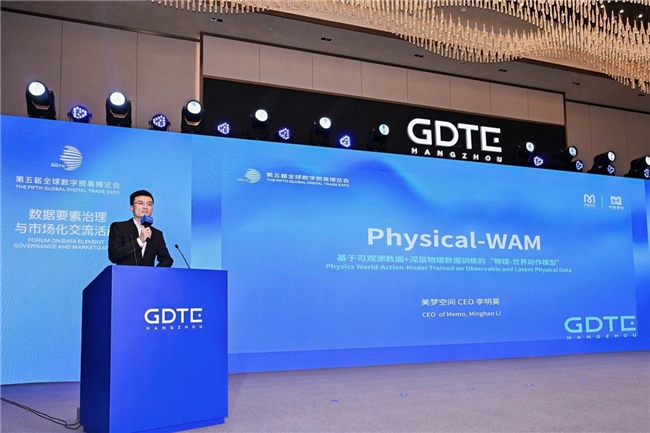
美梦空间CEO李明昊在第五届全球数贸会分享《Physical-WAM,基于可观测数据+深层物理数据训练的“物理—世界动作模型”》
数万倍的数据缺口,具身智能“扫盲”难
具身智能的2026年,热得发烫。
上半年,国内具身智能赛道融资总额达935亿元,较去年同期增长约5倍;人形机器人出货量超4万台,约占全球市场的97%。中国已成为全球人形机器人制造和出货的重要一极。
但热度的B面,是始终未解的“资本热、落地难”。有投资人直言:“订单曲线追不上融资曲线。”
这道难题的根源,美梦空间CEO李明昊在《Physical-WAM,基于可观测数据+深层物理数据训练的“物理—世界动作模型”》主题分享中,拆解得很清楚:机器人缺少对物理世界的基础认知,是双重困境叠加的结果。
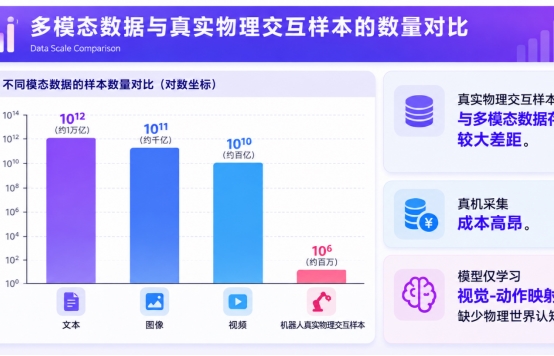
机器人与文本、图像、视频相比,训练数据与样本稀少
第一重困境来自数据鸿沟。机器人的真实物理交互样本仅有百万级别的数据存量,与文本、图像、视频等数十亿级的训练素材相比,中间存在近几万倍的巨大差距。真机采集物理交互样本成本高昂,绝大多数模型只能学习视觉画面与动作之间的映射关系,如同只会“死记硬背”的学生,本质上只是在模仿见过的动作,并不理解背后的物理规律。
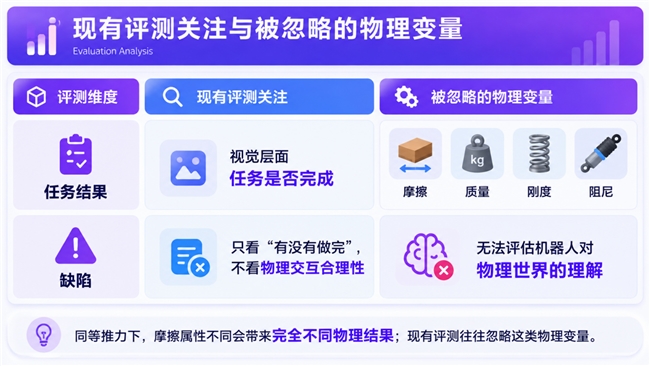
现有测评关注与被忽略的物理变量
第二重困境是测评标尺的缺位。现有的评测体系大多只关注视觉层面任务完成度,忽略摩擦、质量、刚度这类看不见的物理变量。比如,同等推力下,高摩擦的罐子原地倾倒,低摩擦的罐子直接滑飞;夹持擀面杖同一位置,重心偏移就会引发杆体摆动。这些现实世界中大量司空见惯的“物理漂移”,却很难在传统测评中得到有效验证。一项能力无法被度量,模型的迭代优化就失去了锚点。
两个困境,对应两个答案。美梦空间的解法,是一套全新的技术架构。
Physical-WAM:让具身智能从“模仿”到“理解”
美梦空间专注于世界模型的研发与应用,由北京大学信息技术高等研究院高文院士领衔的AVS先进视觉系统研究中心孵化,核心团队在具身智能、视频编解码、空间计算、人工智能领域积累了深厚的研究经验,兼具学术深度与工程落地能力。
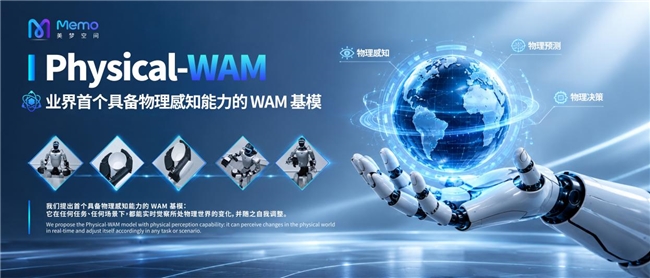
Physical-WAM概念图
Physical-WAM正是美梦空间给出的第一个答案。作为业内首个具备物理感知能力的WAM基模,它基于可观测数据与深层物理数据进行训练。与传统模型的关键差异在于:传统模型可以推演物理世界的演化,但无法感知物理本身——它知道“下一帧画面会变成什么样”,却不知道“为什么会变成这样”。而Physical-WAM能在真实任务中实时觉察物理变化,并预判动作后果、实时修正行为。
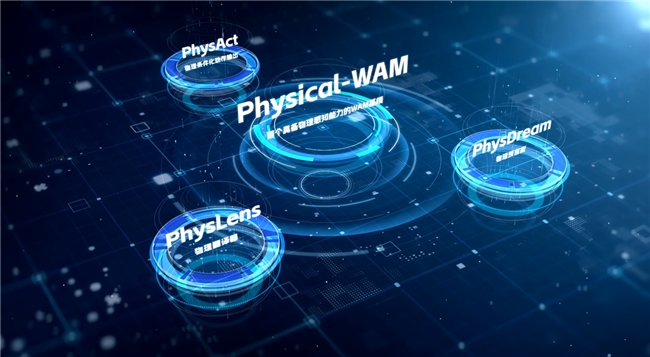
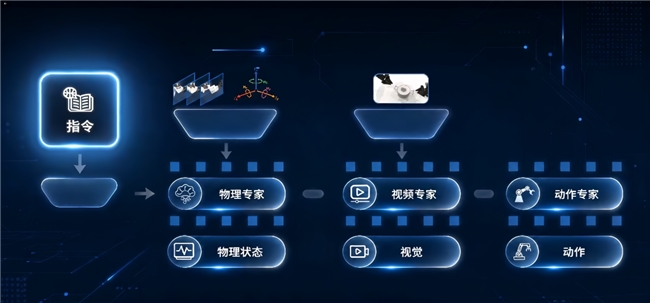
Physical-WAM三大模块架构图
这一能力架构由三大模块协同实现。PhysLens扮演“物理翻译器”,从多模态感知信号中提取摩擦、重量、重心、接触状态等不可直接观测的物理信息,输出统一的物理Token表征;PhysDream是“物理预言家”,结合当前物理表征、环境状态与候选动作推演未来物理状态变化,预判打滑、脱手等风险,并给出不确定性评估;最后,PhysAct负责物理条件化动作输出,把物理属性与未来状态预测引入动作生成,当环境发生物理漂移时自动调整执行策略。
这三者构成了“感知→预测→生成→修正”完整闭环。举一个直观的例子:机器人抓握纸杯时,PhysLens识别出纸杯材质的低刚度特性,PhysDream预测注水后负载增加可能导致杯壁形变或滑脱,PhysAct据此调整抓握力度和接触位置,在注水过程中持续修正策略,直至完成操作。
这不再是简单的动作复现,而是像人类一样,凭借“物理直觉”随机应变。
RoboTwin-Phys:给“物理智能”立一把标尺
模型之外,美梦空间的第二个答案是一把评测标尺。
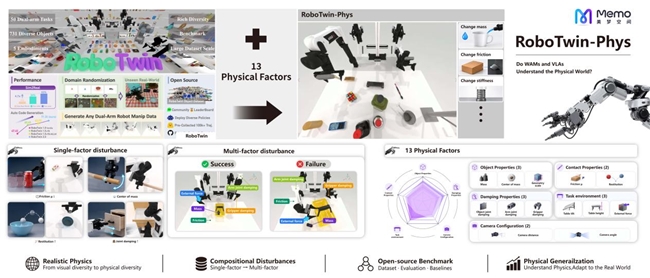
2026年8月,美梦空间获得上市公司索辰科技的独家种子轮战略投资,双方形成“物理AI赋能模型训练、世界模型反哺产业落地”的正向创新闭环。随后,其联合北京大学、北京大学信息技术高等研究院和索辰科技开源了RoboTwin-Phys物理漂移测评基准,这是业内首个以物理因素扰动为核心评测对象的机器人操作基准。
RoboTwin-Phys概念图
这套评测基准遵循三层递进逻辑:物理属性推断准不准、物理扰动下任务还成不成、性能差距的上界在哪里。在RoboTwin的基础上,新增了13类真实世界常见的物理扰动因素,包括物体属性、接触属性、阻尼、任务环境到相机配置五大维度,支持单因素扰动到多因素组合扰动。
这套基准的核心价值在于,把现实中抽象的物理参数,转化为可控、可标记、可复现的变量,让“物理智能”有了可量化的衡量标尺。
具身智能“GPT时刻”还有多远?
具身智能与世界模型尚未迎来类似大语言模型的“GPT时刻”。
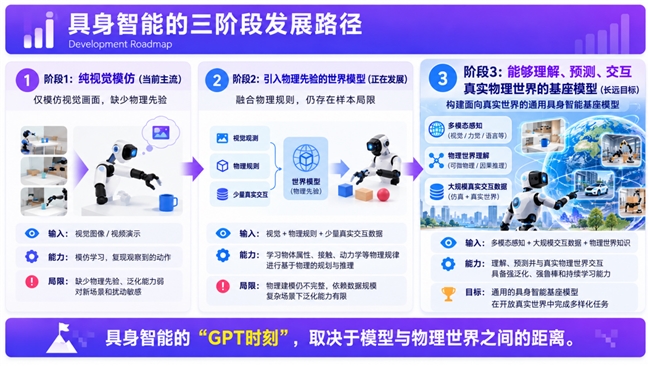
宇树科技创始人王兴兴曾给出了一个衡量标准:当一台机器人被带到任意陌生环境中,通过语音或文字指令,能够自主完成约80%的任务时,产业将迎来爆发的临界点。“快的话可能2—3年,慢的话5年甚至10年。”银河通用创始人王鹤的坐标系则更直白:今天的具身大模型大约处于GPT-2水平,预计到2028年,才能摸到GPT-3.5至GPT-4的门槛。
具身智能的三阶段发展路径解析
时间表的分歧背后,指向的是同一个缺口。业界专家提出,目前几种类型的世界模型,距离成为真正能理解、预测、交互真实物理世界的基座模型都还有较大差距。换句话说,“GPT时刻”的距离,很大程度上就是模型与物理世界之间的距离。
目前业内世界模型逐渐分化为四类:表征式世界模型主打抽象化推演世界,生成式世界模型主打像素级复现世界,交互式世界模型主打三维交互模拟世界,理解生成预测一体化世界模型则主打生成物理认知,实现具身本体自由操控。
美梦空间走的是“理解生成预测一体化”的方向。推演世界只是手段,让机器人像人一样理解物理世界,实时调整动作策略才是目的。目前,公司已形成“数据-模型-测评”三位一体的产业协同生态。从产业落地节奏看,有望率先在工业操作、物流搬运、服务机器人等场景,探索物理数据、模型能力与真实场景的联合验证。
下一步,美梦空间将沿着“视觉先行,力触声递进”的路线持续迭代多模态物理表征,扩充物理交互数据集,优化模型推理延迟与多本体适配能力,并联合产业链上下游补齐物理数据、世界模型、评测标准三块拼图。
“只有让机器人真正读懂物理世界,具身智能才能大规模从实验室走向真实产业场景。”李明昊表示,美梦空间将以开源开放的态度,推动行业加速走向具身智能的“GPT时刻”。