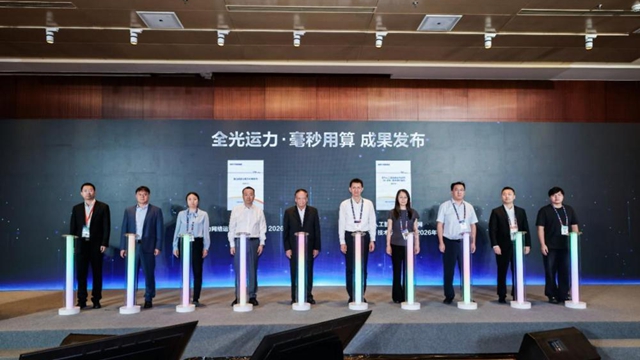





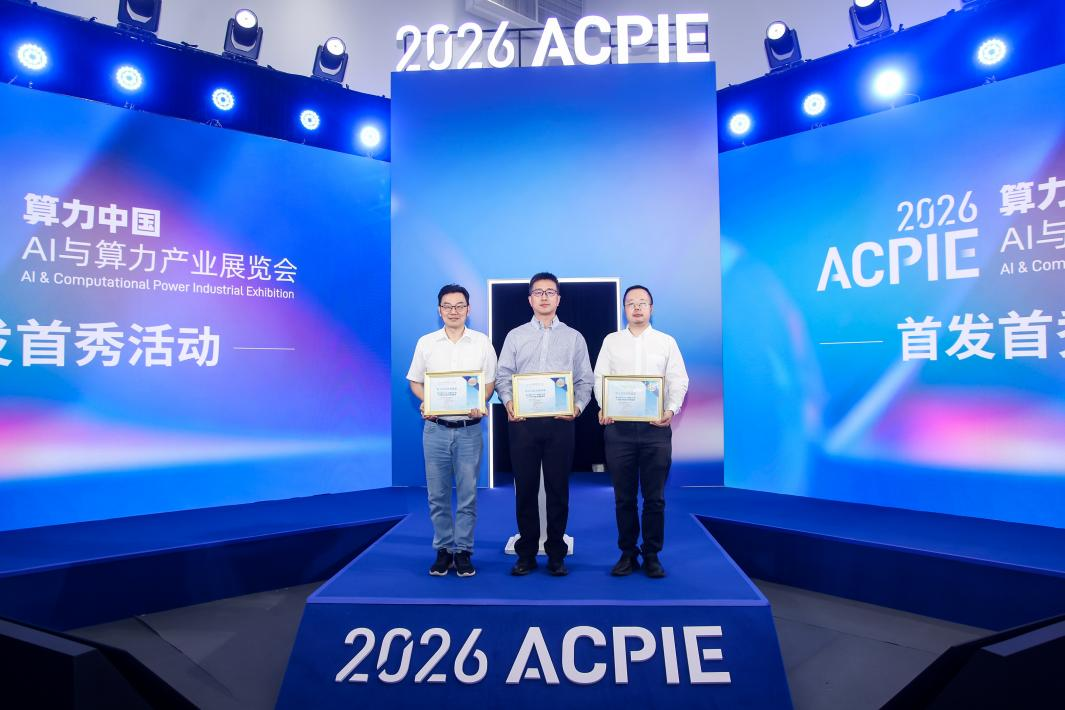
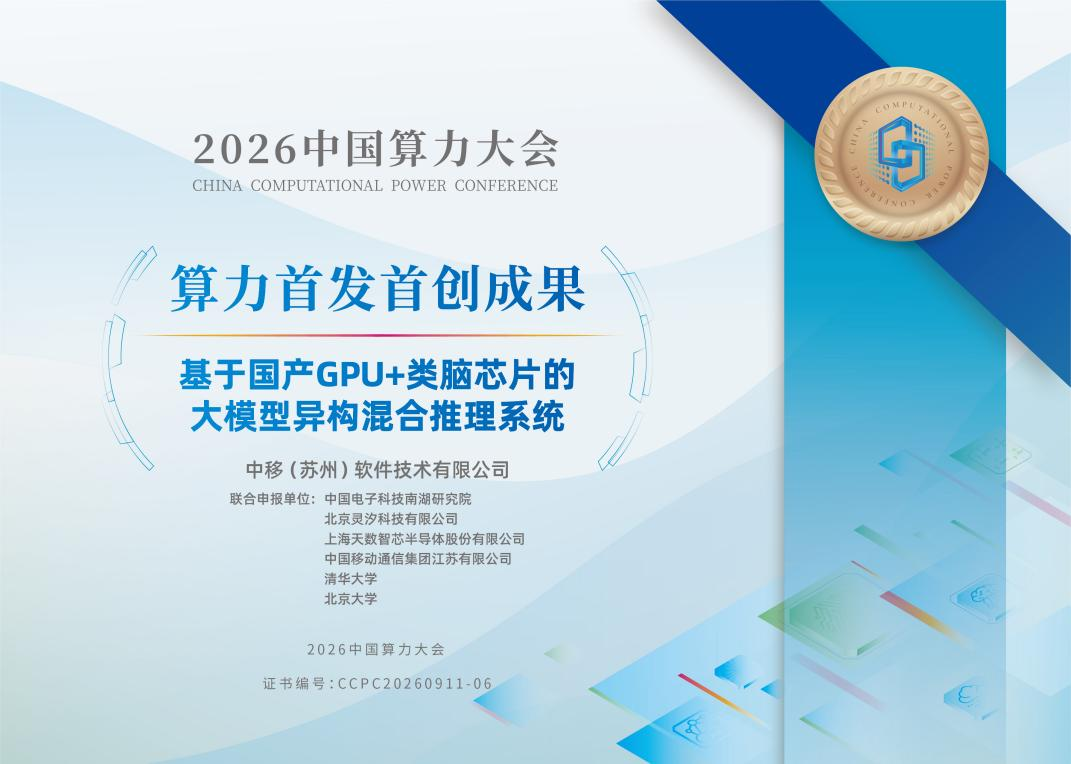
2026中国算力大会“算力首创首发发布会”专场上,由移动云公司联合中国电子科技南湖研究院、北京灵汐科技、上海天数智芯、江苏移动、清华大学、北京大学共同打造的国内首个国产GPU+类脑芯片大模型异构混合推理系统正式发布。该系统通过全栈架构创新,让国产芯片也能高效支撑大模型推理,为国内大模型、多智能体应用提供一条自主可控的新算力路径。
大模型推理进入爆发期,传统架构遭遇双重瓶颈
随着人工智能产业重心从模型训练转向规模化推理服务,推理算力已经成为支撑Token工厂、AI智能体、文生视频等业务的新型数字基础设施。大模型并发服务对吞吐量、能耗成本提出极高要求,传统单一GPU推理架构越来越吃力。一方面,数据频繁搬运会带来“内存墙”和“功耗墙”;另一方面,国内先进芯片制程供给受限,单纯靠硬件工艺升级提升算力,空间有限。行业需要跳出“只追先进制程”的思路,从系统架构层面寻找新解法。
国产GPU与类脑芯片分工,混合推理技术实现突破
项目团队从系统架构创新入手,首次将国产通用GPU与类脑芯片深度融合,打造对标英伟达下一代国际先进异构推理方案的国产化系统。创新实现Transformer模型AF分离推理模式:将Attention(注意力)计算与FFN(前馈网络)模块拆分,由不同特性的国产芯片分工处理。Attention计算交由国产GPU承载,FFN模块交由类脑芯片处理,充分发挥类脑芯片存算一体、片上大容量SRAM的架构优势,突破传统GPU推理的固有瓶颈。
同时,团队自研模型编译器、高速互联协议和统一推理引擎,实现两类算力的任务拆解、协同调度、结果聚合,真正实现两种架构算力优势互补。项目已在Deepseek V4 Flash 大模型上完成完整调优验证,相较同类国产GPU算力集群,推理输出和能效均提升1倍以上、业务运营成本降低40%以上。
这意味着,依托国内成熟工艺的国产芯片,通过系统架构创新,可以实现对标国际下一代推理架构的业务能力,为大模型推理国产化落地提供可复制的技术范式。
产学研协同共建,面向多场景推进落地开放
该成果是产学研用协同创新的典型实践,整合运营商、芯片企业、科研院所、高校多方力量,打通从底层芯片适配、推理引擎开发到业务场景验证的完整链条。后续团队将持续迭代异构推理系统,面向Token工厂、AI代码开发、文生视频、多智能体协同、智能制造、金融通信安全等场景开展落地验证,并计划将核心异构推理框架逐步开放,赋能国内GPU、类脑芯片厂商及算力运营商,带动国产算力产业链整体发展。
本次异构混合推理系统在中国算力大会首发,为智能体时代的AI推理提供国产化全新算力底座。以架构创新弥补工艺约束,这一方案也为国内AI算力自主发展提供重要的创新参考方向。