




企业里最贵的知识,往往不在模型里。
它在告警系统的字段里,在设备手册的 PDF 里,在配置规范的表格里,也在老师傅处理故障时那句"先看传输"里。大模型能写代码、能写报告,却常常答不出一个最具体的问题:"我们这台设备退服了,接下来该怎么办?"
过去两年,检索增强生成成了企业给大模型"补课"的标准答案。但多数方案只做了两件事:把文档切碎,把相似的片段找回来。片段之间是什么关系、一条告警会沿哪条链路传播、同一个词在不同系统里是不是同一个东西——这些真正决定答案对不对的问题,被留给了模型的"猜"。
刚刚中兴通讯开源的 Knowledge Studio 想补的正是这一段:先把业务建模,再把知识抽成图谱,最后用一条可追溯的检索链路,把答案交还给业务。两句话概括它的主张:把散落的企业知识用业务模型组织起来,填平语义鸿沟;让每条答案都可追溯、可校验、可运维。
一、AI确定性问答的三条路:精调、检索、知识库
企业想给大模型补上自己的知识,眼下大致有三条路可走:把知识精调进模型权重,只做检索增强,或者把知识认真建成一套能推导、能核对的库。三条路都能跑起来,但放到"答案必须确定"这个要求下,代价和边界很不一样。
先把知识分成两种:一种是"参数化知识",训练时压进模型权重;一种是非参数化知识,存在模型之外,可以增删改查。精调是把知识变成参数,检索和知识库是把知识留在外部,推理时再把上下文找回来。前者更新贵、难追溯;后者更新快、能给出处。
1. 第一条路:把知识精调进权重
这条路不划算、跟不上,也扛不住。一次精调要数据清洗、标注、算力、评测,周期以周计;而企业知识每天都在变——新故障、新工单、新配置、新规范,等模型训完,材料可能已经过期。
它还有一笔隐性成本:精调是在改模型的"手感"。知识记住了,别的能力可能一起退化;一条事实要改,往往得重训。对多数企业来说,既没有卡,也没有算法团队,不可能一个场景精调一个模型。
精调真正擅长的是技能与风格——让模型学会一种写法、一套话术、一类判断习惯;它不擅长需要被反复修改、反复核对的事实。
2. 第二条路:只做检索增强,把相似片段找回来
RAG 的核心是"检索增强":把文档切碎、向量化,检索回相关片段,补进上下文。它对"文档里写了什么"很有效,工程上也最容易被接受;它的短板在"关系"和"推理"——一个告警为什么会导致退服,一条根因到处置方案经过哪些关系,向量相似度答不了。
从检索单元看得更清楚:RAG 找的是"文本片段",相似是局部的;多跳问题要的是"关系连通"。答案需要的事实分散在不同文档里,向量能找回"像"的片段,却保证不了"连得上",最后那一步只能交给模型去拼、去猜。
片段本身也不带类型和指向:它是告警描述还是处置规范,它指向哪个设备、哪条链路,检索层并不知道。相似度能排序,但排不出因果顺序。
3. 第三条路:把业务模型建起来,让答案走一条链
这条路先做一件前两条路都不做的事:业务建模。实体、关系、属性被显式定义成一套 Schema,Schema 不是给程序员看的表结构,而是业务专家和 AI 之间的契约——哪些概念存在、它们怎么相连、哪些字段必须填。
契约在前,知识在后。导入时做类型、主键、边端点校验,模型不能随手造一条不存在的边;检索时沿图上的边走,答案带着一条可展开的路径;输出时仍回到原文片段,每一步都能核对。约束强、路径可见,幻觉自然被压下来——这是机制,不是口号。
三条路比下来,结论其实很朴素:精调擅长技能,不擅长会被频繁修改的事实;只做检索擅长找回原文,不擅长回答"为什么"和"然后呢"。在确定性要求高的场景里,把知识建成一套带业务模型、能沿关系走、能回到原文的知识库,是当下最靠谱的一条路。
它也不排斥另外两条路。产品通过编排把"图谱检索"和"文档检索"配成同一条工作流,按任务类型和提示词配置路由:推导型任务(故障根因、影响分析)要路径和约束,走图谱;操作型任务(参数、步骤、手册)要原文细节,走文档;复杂任务两条路并行,再把结果融合。
比如"小区退服怎么排查"是推导型,走图谱:小区 → 告警 → 传输中断 → 光模块故障 → 更换光模块;"这个参数怎么配"是操作型,走文档:检索故障手册、配置规范。两条路的结果可以放在一起看,冲突怎么处理由使用方决定。不是二选一,而是按任务路由。
二、一次"小区退服",照见企业知识的两道坎
以无线网络运维为例。某小区突然退服,工程师要在告警系统里看告警、在台账里查站点和设备、在手册里找处置步骤、在历史工单里找先例。知识散在多个系统里,术语还各说各话:"退服"在有的系统叫 out of service,"告警"有的叫 alarm,有的叫 warning。熟练工程师要在几个系统之间来回切换,新人只能问老师傅。
在中兴开源的 Knowledge Studio 里,这个过程被压缩成一次提问:"某小区退服,可能是什么原因,怎么处理?"
系统先在知识图谱里定位到"小区"和"告警"两个种子实体,沿 CausedBy 关系走两到三跳:小区退服 → 传输中断 → 光模块故障;再沿 ResolvedBy 找到"更换光模块"的处置方案;同时用向量和关键词召回相关的设备手册、历史工单片段。最终进入上下文的,不是一堆相似段落,而是实体、关系路径和原文片段。
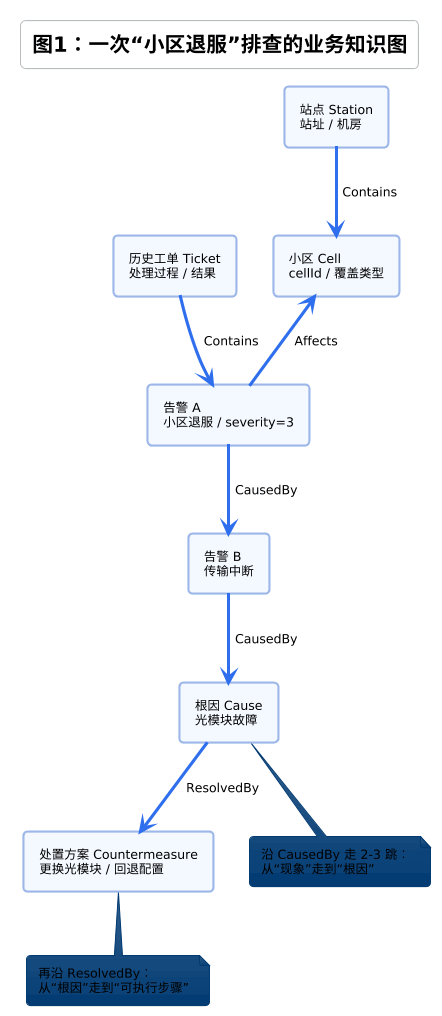
在图谱里,因果链可以逐跳展开;答案里的处置步骤可以逐条核对,每一段依据都能回到原文。过去要在多个系统之间来回翻,现在是一条可以展开的链。
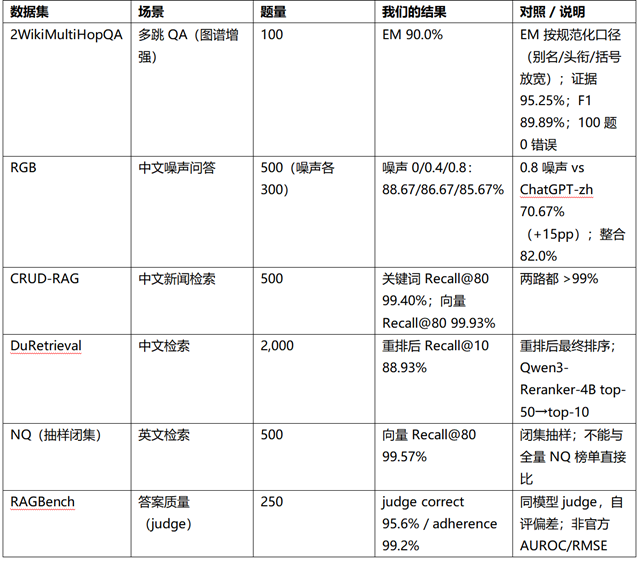
这不是一个演示 Demo。把同一条图谱检索链路放到公开多跳数据集 2WikiMultiHopQA 的 100 题上,图谱增强最佳配置拿到 90% 级的 EM 和 95% 以上的证据召回,100 题 0 请求错误。完整数字、对照组与口径边界见第五节。
三、先建业务模型,再谈检索
这条链能走通,靠的是系统先做了一件很多检索增强方案不做的事:业务建模。
在 Knowledge Studio 的图谱知识库里,业务专家要先定义一套 Schema:有哪些实体(小区、站点、设备、告警、根因、处置方案),实体之间有哪些关系(属于、影响、导致、处置),每个实体有哪些属性(严重级别、发生时间、厂家、处置步骤),哪个属性是主键、哪些要建索引、哪些要向量化。Schema 不是给程序员看的表结构,而是业务专家和 AI 之间的契约:哪些概念存在、它们怎么相连、哪些字段必须填。
契约定好,知识才进来:设备手册、配置规范、历史工单由大模型按 Schema 抽取实体和关系;结构化的台账、配置数据可以整理成 JSONL 实体/关系包直接导入,Excel/CSV 也可以作为文档上传后再按 Schema 抽取;类型不对、主键缺失、边的起点终点不合法,在校验阶段就被拦下。抽取和导入都不是"一次性"的,可以增量、可以去重、可以追踪进度。
这一步的意义,不只是把文档变成三元组。它把"散"和"歧义"一起解决了:散落在不同系统、不同格式里的知识,被同一套实体—关系—属性组织起来;不同系统里的不同叫法,在建模时归到同一个实体类型、同一个主键上。检索不再是在一堆切片里碰运气,而是在一张业务地图上定位。
这也是它和"只做检索问答"最大的不同:它不假设"相似就等于相关"。在垂直领域,两段文字可以长得很像,却分属完全不同的场景;一段告警描述和一条处置规范,字面上可能毫无重合,但在业务上是一条因果链的两端。业务模型把这些关系显式写下来,模型不必靠猜。
四、每条答案,都能回查
第二章说企业知识有两道坎:散和歧义是第一道,解法在业务建模;第二道坎,是敢不敢信。
Knowledge Studio 的做法很朴素:把"依据"做成产品功能,而不是靠模型自觉。对话页的"知识库依据"会列出本轮命中的片段、来源文件、相关度分数和改写后的检索问句,每条依据都能点开、回到原文核对;Agent 接口的问答会返回 [S1] 这样的引用,调用方可以逐条回查,也可以把引用原样展示给自己的用户。
第二件事,是把"没找到"显性化。没有命中时,系统会明确说"没有找到",而不是假装检索过、让模型自由发挥。这样一来,两种失败可以被区分开:是知识库里确实没有这条知识,还是检索链路出了问题——前者要补知识,后者要调检索,混在一起就没法定位。
图谱让"回查"更进一步。向量检索给出的是相似片段,回查的终点是一段文字;图谱检索给出的是一条路径——从告警到退服、从根因到处置,每一跳走的是哪条关系、指向哪个实体,都可以展开核对。多跳答案不是靠模型把几个片段"拼"出来的,而是沿着图上的边走出来的:路径本身,就是依据。
能回查,只解决了"答案有据可依"。可靠性还有一个更硬的考验:同一条链路,在干净文档上能答对,混进大量无关内容之后还能不能答对?下一节用六组公开数据集来量这件事。
五、真实文档倒进去,还剩多少准确率?
多跳基准证明"关系型问题能答",但企业更关心的是:真把大批真实文档和问题倒进去,换个语料、换个任务,准确率还剩多少?这一节用六组公开数据集来回答,相当于把"多产品、多文档"拆成六组可复跑的切片:多跳 QA、中文噪声问答、中文新闻检索、中文检索、英文检索、答案质量。
选这六组,是因为它们分别对应企业知识库最常见的几类问题:多跳关系(2WikiMultiHopQA)、中文检索的召回(CRUD-RAG、DuRetrieval)、文档混入噪声后还准不准(RGB)、英文检索够不够稳(NQ)、答案质量够不够高(RAGBench)。每组都给出题量和指标,不把不同指标合成一个总分。
数据来源:中兴通讯 Knowledge Studio 团队公开数据集复跑记录(docs/rag-benchmark-20261101.md)
第一,图谱增强把"多跳"做起来了。它的价值不在单跳事实题——那些题加不加图差别不大——而在把分散在不同文档里的因果链连起来。多跳问题需要的就是这种连通,这也是图谱和纯向量检索拉开差距的地方。
第二,噪声下的稳定性是这套链路最实用的长板。从干净文档一路加到 0.8 噪声,准确率只掉了 3 个百分点,而同题对照的公开值掉了 25 个百分点。对企业来说,这意味着知识库不用先彻底打扫干净才能用——存量文档杂乱是常态,链路本身有不被无关内容带偏的能力。这一点比分数本身更值钱。
第三,检索底座在中英文上是稳的。中文靠关键词与向量双路召回保证"不漏",靠重排把对的答案排到前面;同一套链路换到英文大语料的抽样闭集上同样稳定。答案质量一项,correct 与 adherence 都在 95% 以上,completeness 还有提升空间,所以这组数字只作旁证、不进结论。
这六组数字都是闭集或抽样口径,题量 100–2,000,几个点的差异不构成稳定优势,也不和全量榜单直接比。它们回答的是一个更具体的问题:在同一套公开题上,图谱、关键词、重排和噪声鲁棒性各自带来了多少。它们不承诺在每个企业语料上都能拿到同样的分数——换到自己的语料,结论要用同样的方法复测,复测配置在仓库 README.md 与 docs/rag-benchmark-20261101.md,多跳端到端仍有提升空间。
六、Knowledge Studio 开源了什么?
本次开源的 Knowledge Studio 采用 Apache-2.0 协议,包含一套能独立跑通的最小闭环:文档知识库(md / docx / xlsx / pdf / pptx / html / txt 等格式的解析、切片、双索引)、图谱知识库(Schema 定义、实体关系抽取、图谱查询与图谱检索)、双路检索与多库优先级、可视化检索编排、SSE 流式问答与知识库依据、模型注册表,以及 REST + MCP 的 Agent 接入面。
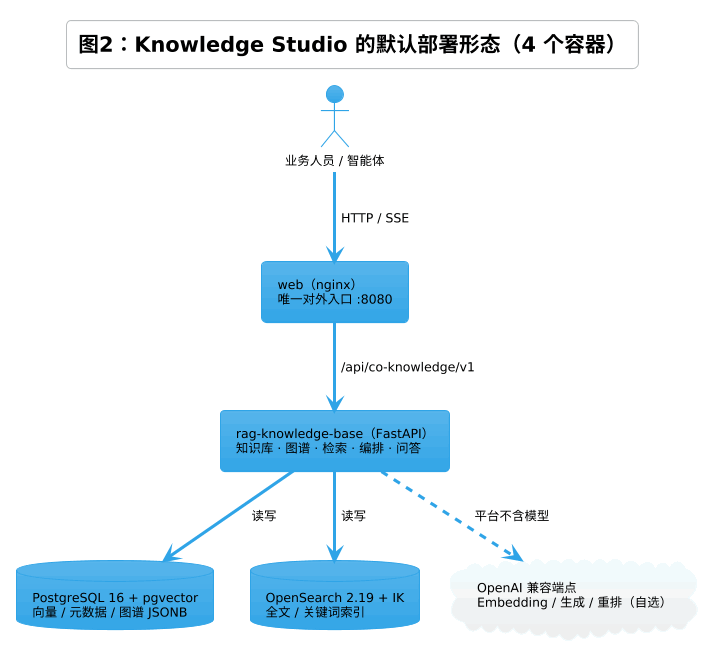
它不是把内部系统整包搬出来,而是把通用能力重新组织成一套能独立跑通的闭环。交付形态也偏向务实:默认 4 个容器起栈——nginx 前端、FastAPI 后端、PostgreSQL(pgvector + 图谱 JSONB)、OpenSearch——对外只有一个 API 前缀;模型端点、库口令、内存限额在一处配置。它不依赖 Redis、Kafka、独立图数据库,企业现成的运维体系可以直接复用。
拿到仓库后,四步起栈:改 deploy/.env 里的数据库口令和模型端点,docker compose up -d,登录 admin 改密,在模型管理里注册 embedding 和生成模型。数据、模型、算力都留在自己的环境里;没有外网,也能用 --no-build 复用镜像离线部署。
仓库地址:https://github.com/ZTE-AICloud/Co-Sight/tree/master/Co-Knowledge
七、结语:从"找相似"走到"走因果链"
过去一年,行业讨论最多的是模型参数、榜单和 Agent 框架。但企业真正缺的,往往不是又一个更聪明的模型,而是一张更懂自己的知识地图:知道哪些概念存在、它们怎么相连、一个结论该回到哪段原文。
这正是"找相似"与"走因果链"的分界:找相似是把最像的段落端上来,走因果链是沿着一条能展开、能核对的路径把结论推出来。前者靠概率,后者靠结构。企业要的确定性,就藏在这一步之差里。
中兴通讯开源的 Knowledge Studio 把这条链的构建方法开放了出来。它不承诺"一句话解决所有问题",但它把三件事做成了可复用的工程能力:用业务建模把散落的知识组织起来,用图谱把关系型问题答出来,用可追溯的检索链路让答案可信。
当大模型从"会说"走向"会做",知识工程会变成和水电一样的基础设施。我们期待更多开发者在这套开源代码上,长出自己的业务模型——让每一次回答,都从"看起来像"走到"说得清为什么"。