




从只会“单步演示”到“连续干完一件活”,长程规划正在成为机器人的新分水岭
当“大脑”成为机器人的分水岭
2026年,具身智能正以肉眼可见的速度从展台走向真实场景。据中国电子学会数据,2026年上半年国内人形机器人出货量已超4万台,全球占比高达97%;海外科技巨头亦在加速入场:OpenAI首席执行官已确认公司将自主研发人形机器人,并直言机器人外观“远不如真正弄清楚如何让机器人大脑运转重要”,计划2027年推出演示样机,核心攻关方向正是驱动机器人运转的智能系统。
从中国制造的规模领跑,到全球巨头押注“大脑”竞赛,行业共识已然清晰:形态不再是分水岭,真正决定机器人能否“干活”的,是具身大脑在复杂场景中的规划、决策与泛化能力。
在这一赛道,一种关键能力正浮出水面——让机器人从“看懂环境”走向“连续干活”的长程规划,正在成为具身智能落地的新分水岭,也为行业打开了一条高性价比的研发路径。
长程规划:具身大脑最陡的一跃
具身大脑被视为机器人从“看懂环境”走向“执行任务”的核心中枢,其感知、推理、规划与安全决策能力直接决定机器人能否真正进入物理世界。而其中长程任务规划,正是公认的能力鸿沟——从单步识别到多步连续决策,从“理解场景”到“拆解任务、规划路径、纠错执行”,是具身大脑从演示走向干活的关键一跃,也是当前头部模型与专项模型差距最显著的维度。
在这一背景下,中兴通讯发布论文《EmbodiedMind: Adaptive Data Curation and Prefix-Tree Reinforcement Learning for Efficient Embodied Intelligence》,以8B模型在18项具身大脑基准上取得70.02%的平均成绩,长程规划准确率较现有最优方法提升30.31%,相关论文已投稿ICRA 2027。
随后,SuperCLUE 9月EmbodiedCLUE-VLA“具身大脑”榜单出炉:中兴通讯Nebula-EmbodiedBrain-180B以77.48分与阿里Qwen3.8-Max-0902并列国内第一,具身安全单项高达97.92分。从8B专项模型的训练范式突破,到180B级大脑模型的综合能力打榜,两条线索合流,表明中兴在具身大脑赛道已走在前列。
三重结构性困境,卡住具身大脑训练
当前具身基座模型的训练,普遍受制于三个结构性缺陷。
其一,样本效率低下。训练语料中大量轨迹信息密度低、质量参差、噪声显著,监督微调与强化学习在冗余与高方差数据上消耗算力,却收敛至次优策略,真正有价值的训练信号被稀释。
其二,异构任务梯度贡献失衡。DAPO等动态采样方法缺乏任务级校准,简单任务被过度丢弃、困难任务被系统性忽视,多任务训练中能力此消彼长,引发“跷跷板效应”。
其三,长程规划中的信用分配严重失真。标准GRPO将轨迹级优势均匀施加于所有token,一条轨迹最终失败,其中间正确的决策也被一并惩罚;树搜索虽可回溯至单步节点,却面临组合爆炸的深度代价,难以在探索深度与计算可行性之间取得平衡。
这三重困境共同指向一个核心命题:具身大脑要从“看懂环境”走向“长程执行”,训练范式本身需要重构。
三重机制协同,系统性破题
为了突破现有具身大脑基座模型训练的瓶颈,研究团队提出了一套三阶段训练范式:以RSFT从源头进行数据清洗与SFT训练、以IR-GRPO重建任务平衡、以Trie-GRPO实现步级信用分配,三层机制各对一题、逐级递进,实现具身大脑训练范式的系统性重构。
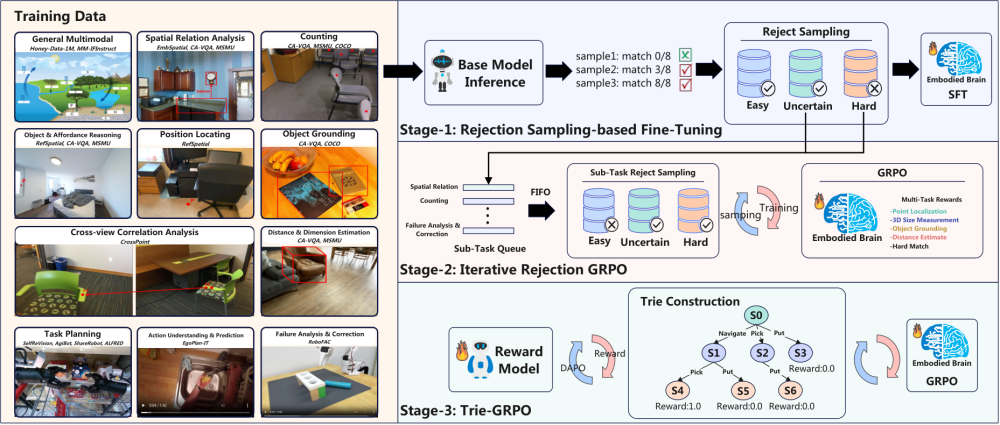
图1 EmbodiedMind 三阶段训练框架(RSFT→IR-GRPO→Trie-GRPO)示意
机制一 · RSFT:从源头提升数据信息密度
针对训练语料中低信息密度轨迹稀释有效信号的问题,该机制以高温度系数多次推理对样本分层:全部生成正确的归为简单样本,部分正确的归为不确定样本,全部失败的归为困难样本。训练集仅保留不确定样本与一定比例的简单样本,暂时排除困难样本,既防止早期分布坍塌,又避免错误轨迹污染,从源头提升数据信息密度。实测显示,该机制在多维度能力评估上全面优于标准监督微调方法。
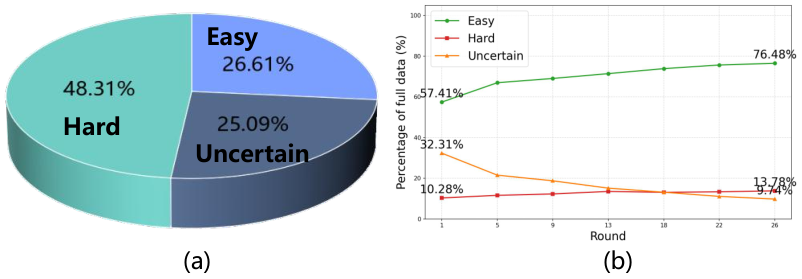
图2 拒绝采样后的训练样本分布(RSFT阶段饼图与IR-GRPO轮次变化)
机制二 · IR-GRPO:重建异构任务平衡
针对GRPO动态采样缺乏任务级校准、易致能力此消彼长的问题,该机制为每个任务类型维护独立的先进先出队列,并以指数移动平均平滑各任务的有效样本比例,动态调整下一轮采样配额,确保各类任务在训练中的数据比例保持均衡。配合专为多样化具身任务设计的专属奖励机制,实验表明,该机制在提升模型综合能力的同时,大幅缩短了训练时间。
机制三 · Trie-GRPO:步级信用分配
其核心洞察在于:策略优化的“组”不应定义在完整轨迹层面,而应在动作前缀层面条件化。所有采样轨迹并行插入一棵动作前缀树,共享同一历史前缀的轨迹在分叉点形成独立决策子组,相对优势严格限定于兄弟节点之间计算。
这意味着,即使一条轨迹最终失败,其中间正确动作仍可获得正向局部优势,彻底摆脱“连坐”惩罚;分叉点上的正确与错误动作被直接对比,优势信号精确到步。为控制探索成本,该机制以折扣回报沿树路径回传、兄弟节点归一化计算优势,并过滤近零优势样本,在探索深度与计算可行性之间取得原则性平衡。
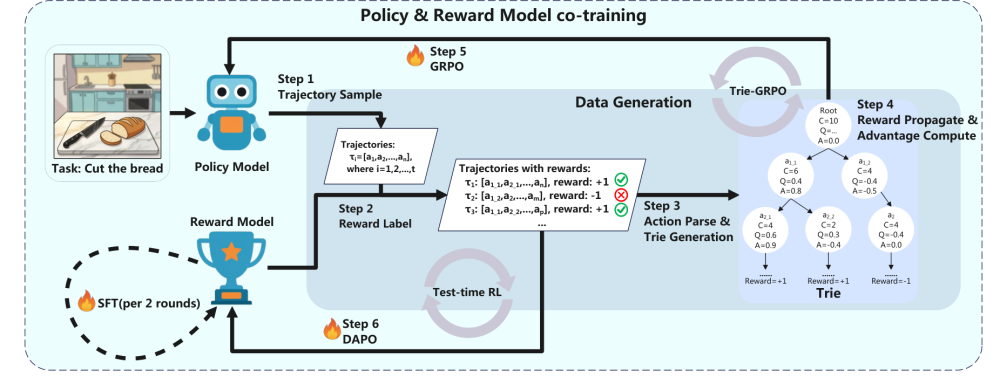
图3 Trie-GRPO 自动迭代训练框架(策略与奖励模型联合训练)
从18项基准到物理世界,用数据证明
EmbodiedMind-8B仅使用52.2万训练样本,便在18项具身大脑基准上取得70.02%的平均成绩,综合能力超越同量级开源模型。这18项基准覆盖四大能力块:通用多模态理解、2D空间推理、3D空间度量与任务规划,涉及计数、目标定位、距离度量、尺寸度量、规划步骤生成、动作预测等任务,较为全面地检验了模型从环境理解到任务执行的能力谱系。
在此基础上,研究团队进一步在仿真环境中验证长程任务规划能力:在VLM-PlanSim-99这一最长25步规划任务的基准上得分66.67,超越Cosmos3-Nano达到业界一流水平;在ALFWorld-thor测试集上,则以60.45%的成功率超越SEEA-R1的46.27%。
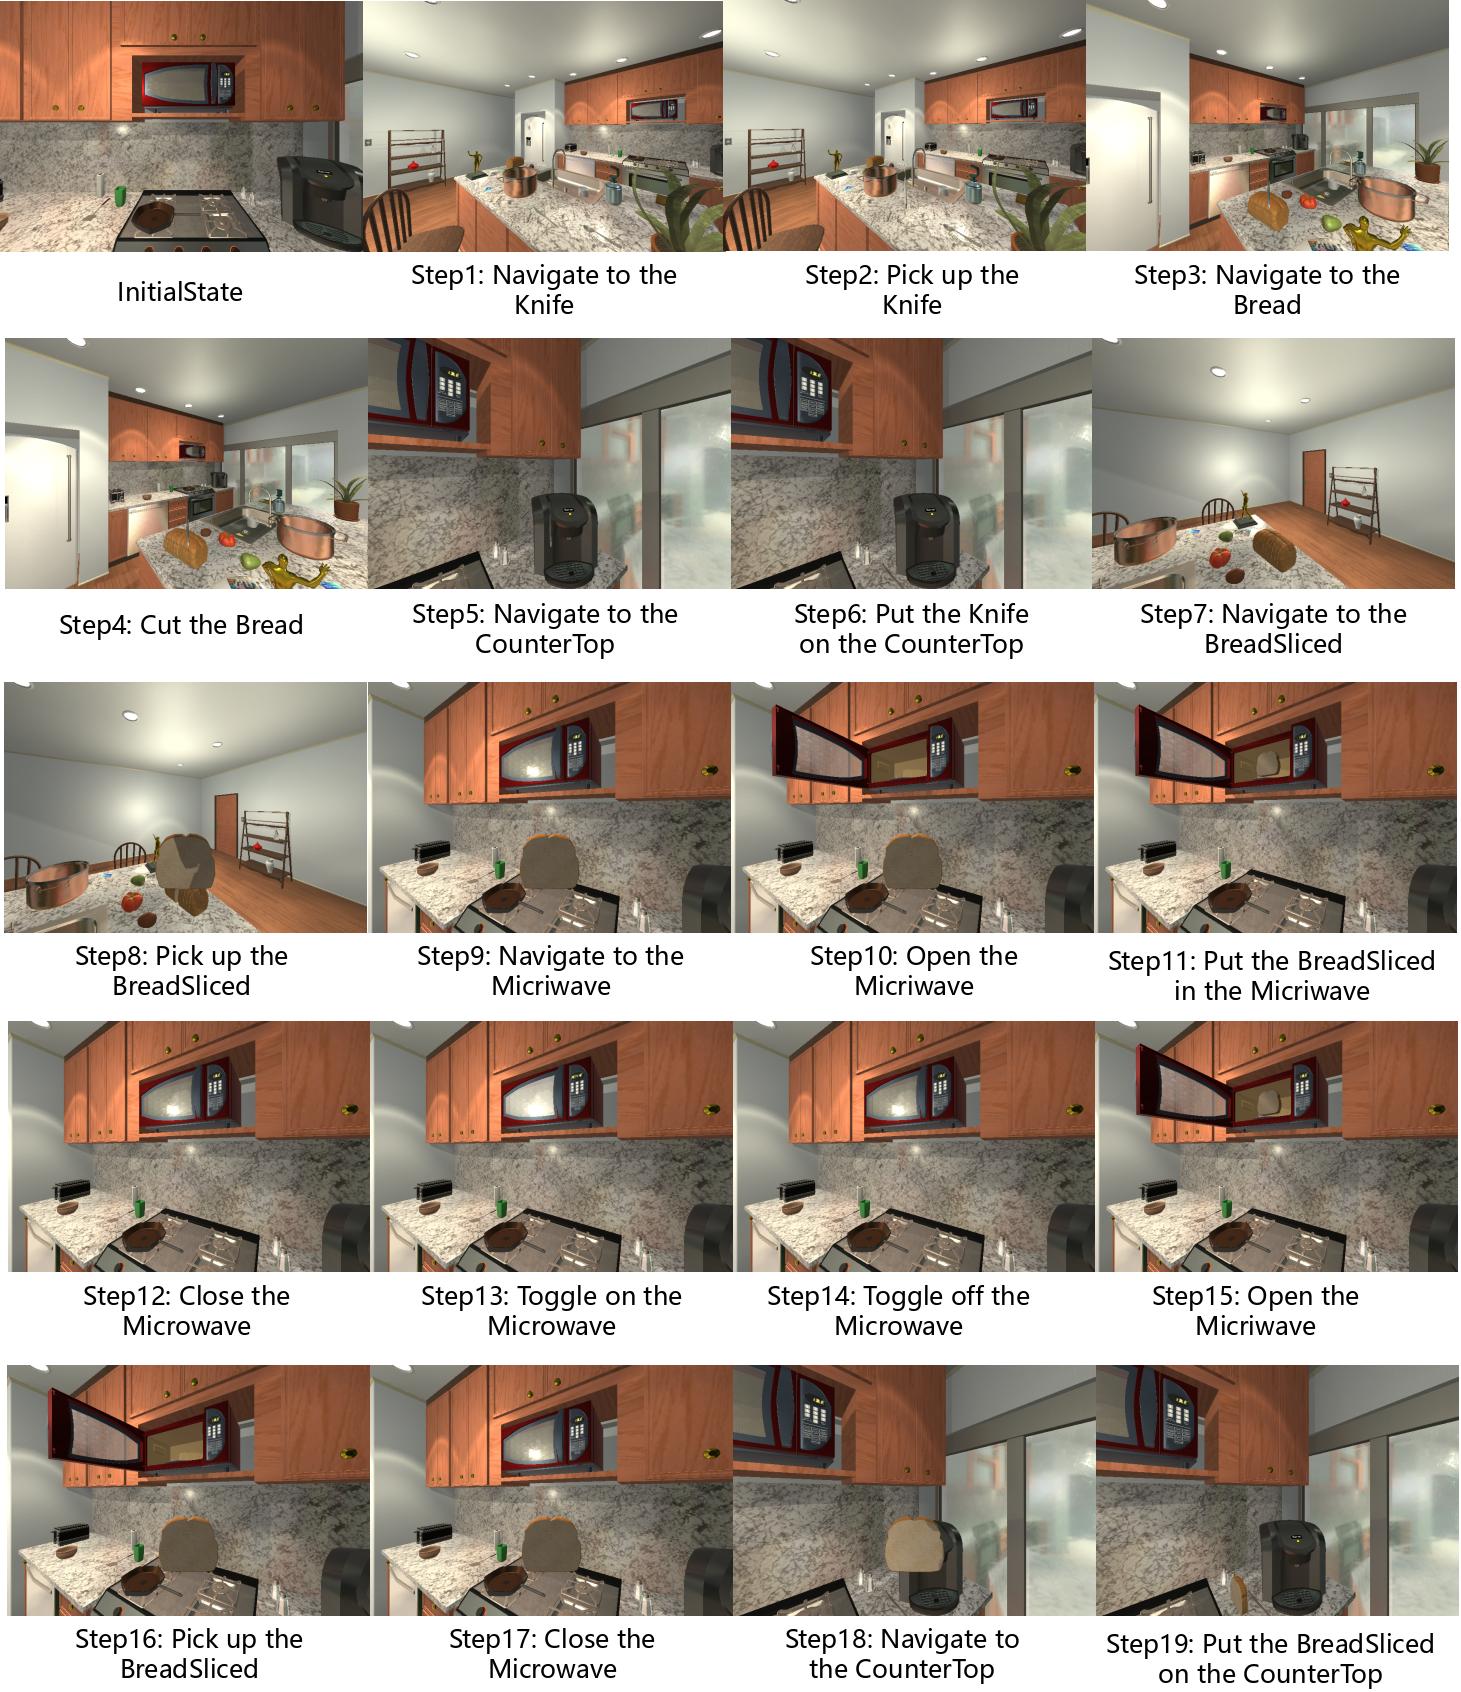
图4 长程规划可视化:仿真环境中“制作并加热切片面包”的19步连续任务规划
更具说服力的是真机验证。研究团队基于AgiBot A2机器人构建了50个桌面场景,并采集了160条任务执行监控视频构建A2-Failure数据集,EmbodiedMind在桌面整理规划任务上达62.00%,远超Qwen3-VL-8B的40.00%这一基线;任务执行监控准确率55.31%,同样领先于Qwen3-VL-8B的46.88%。这意味着通过Trie-GRPO在仿真环境中习得的步级信用分配能力,能够有效迁移至真实机器人场景——长程规划不再止步于基准分数,而是在物理世界中兑现为可观测的成功率提升。
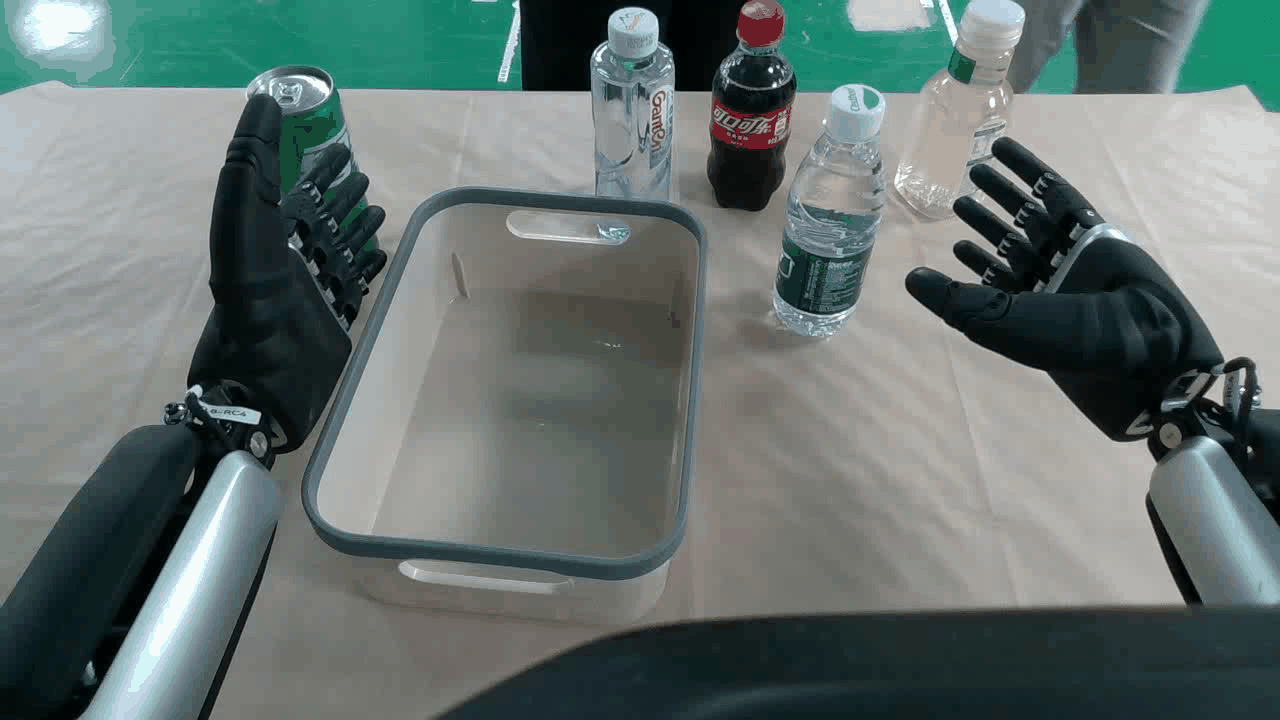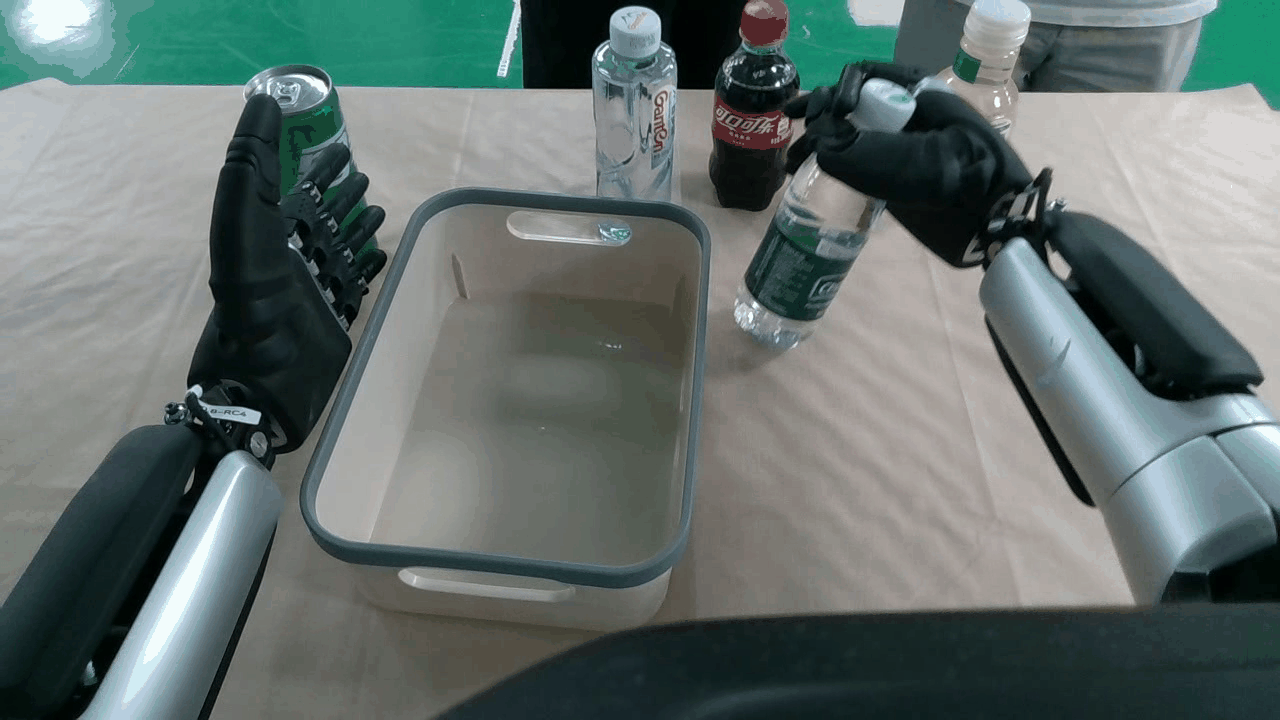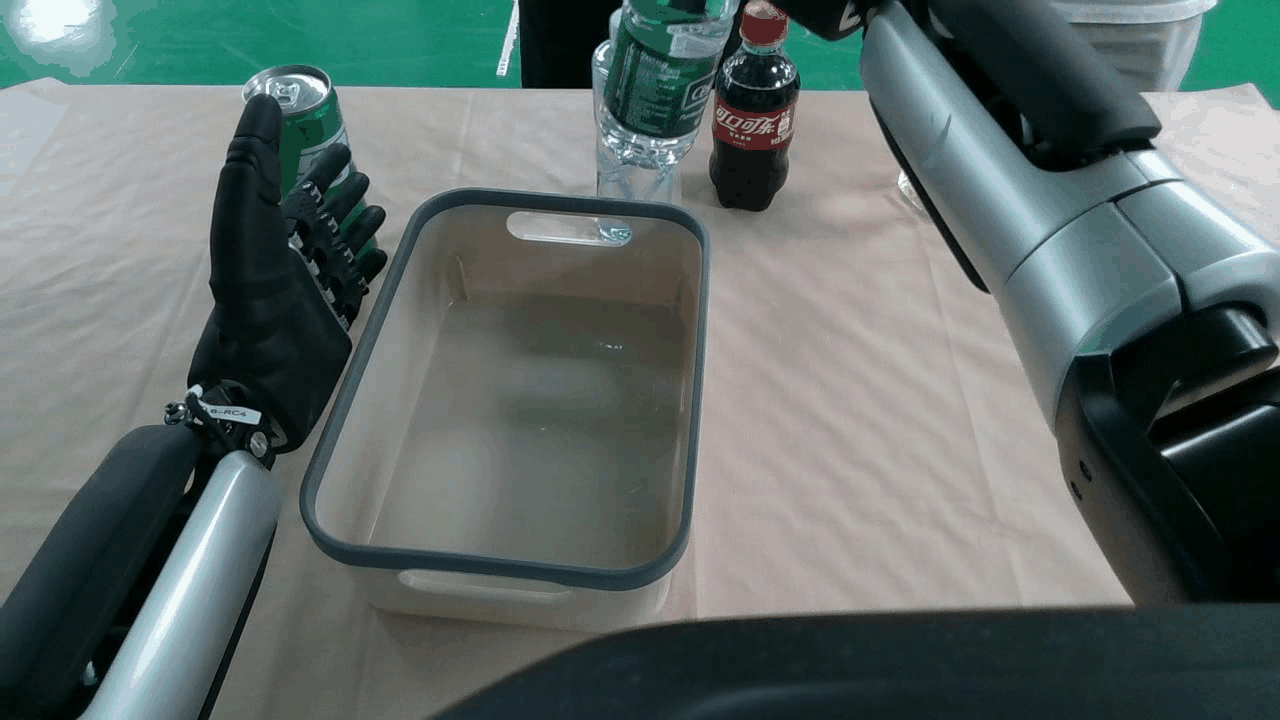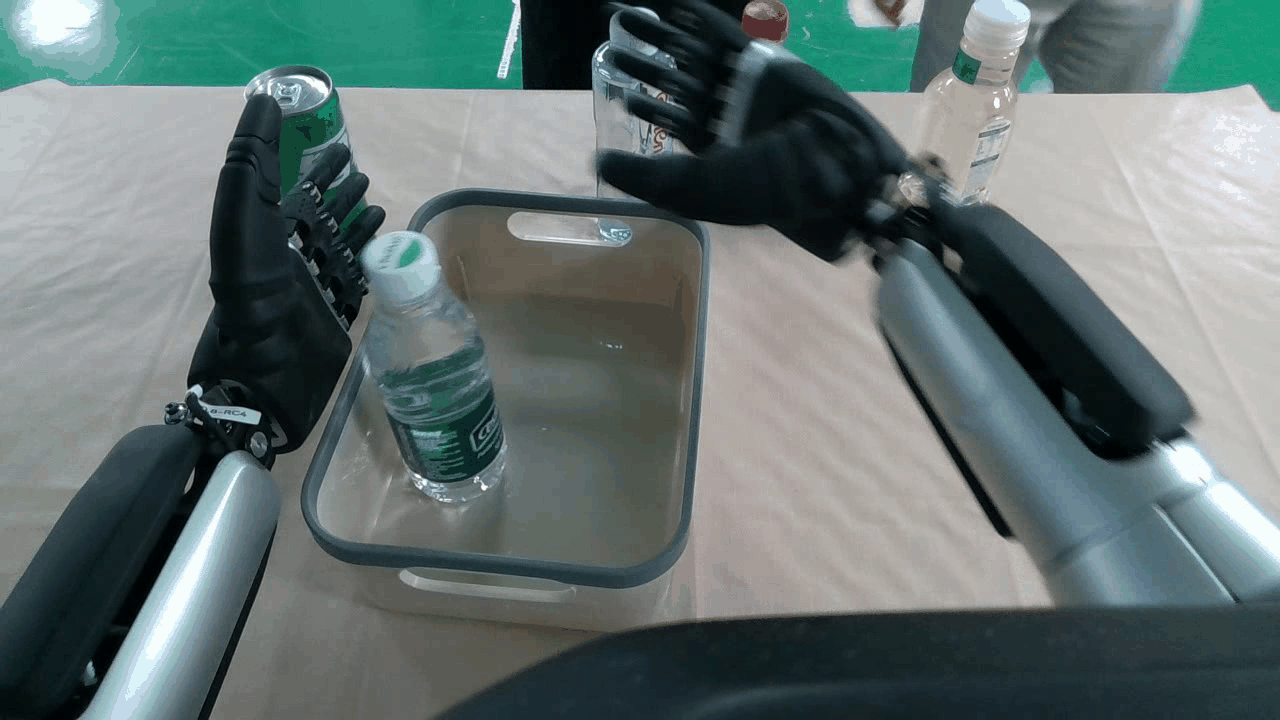
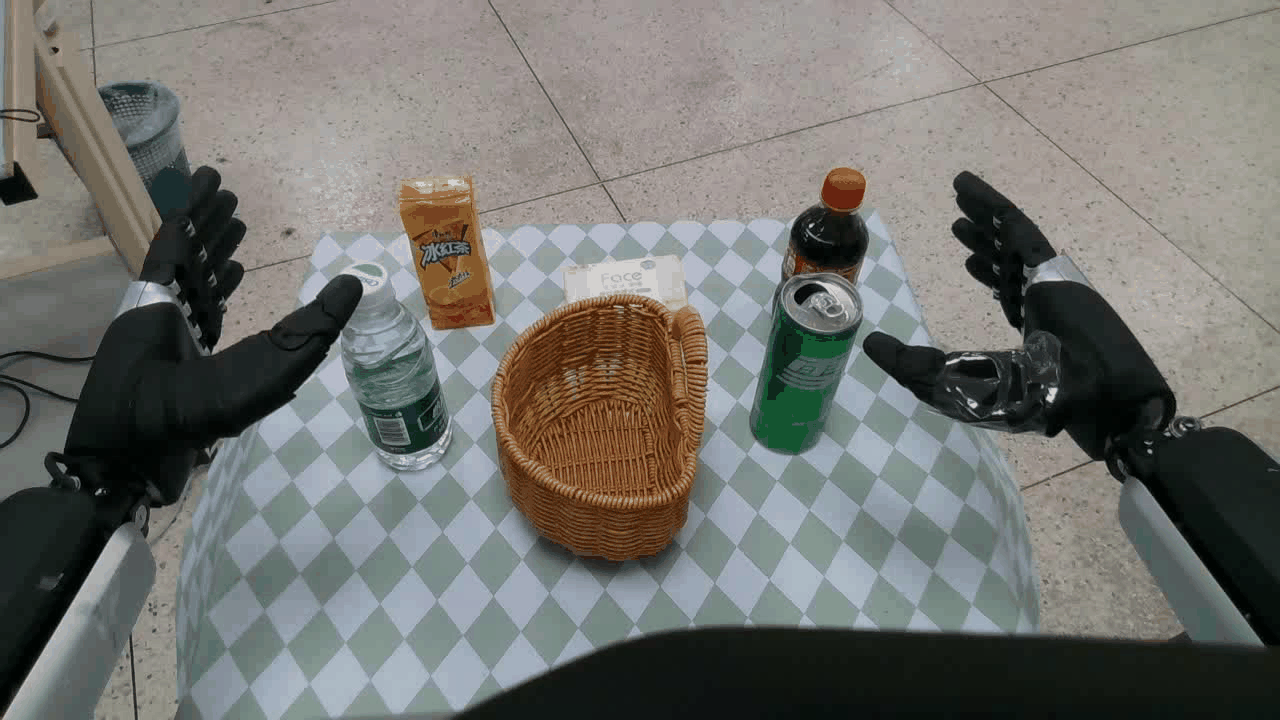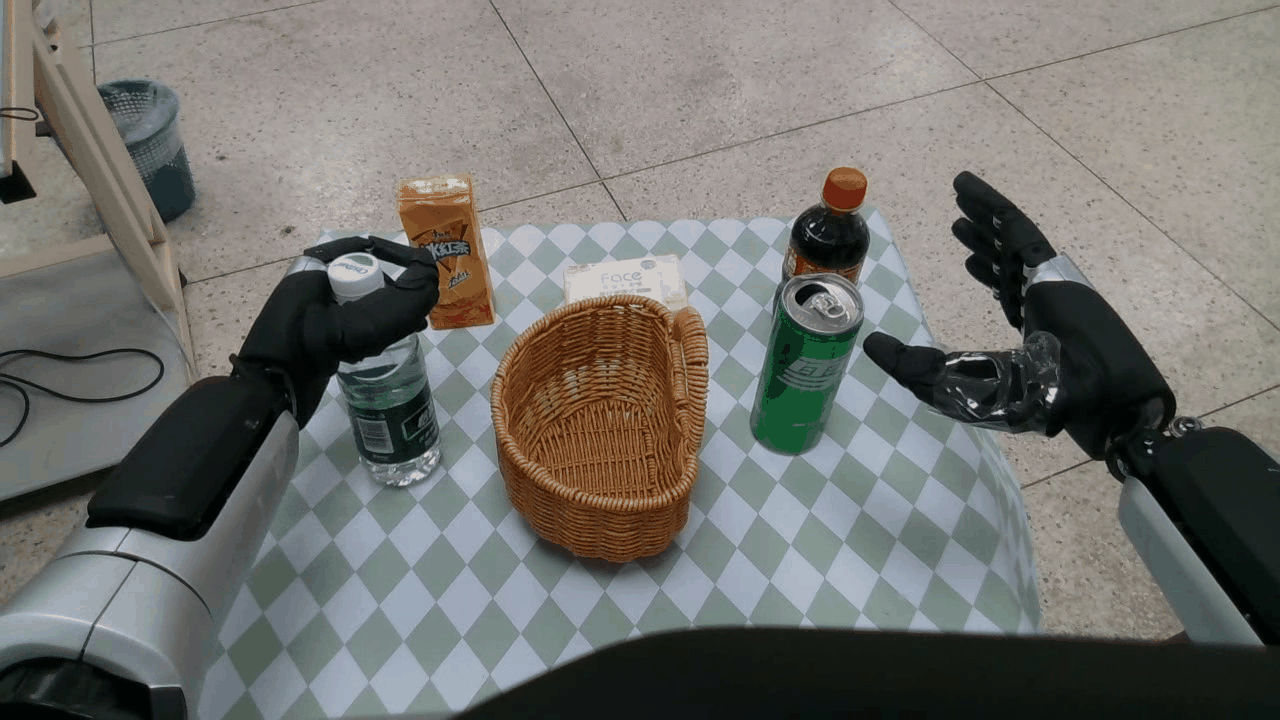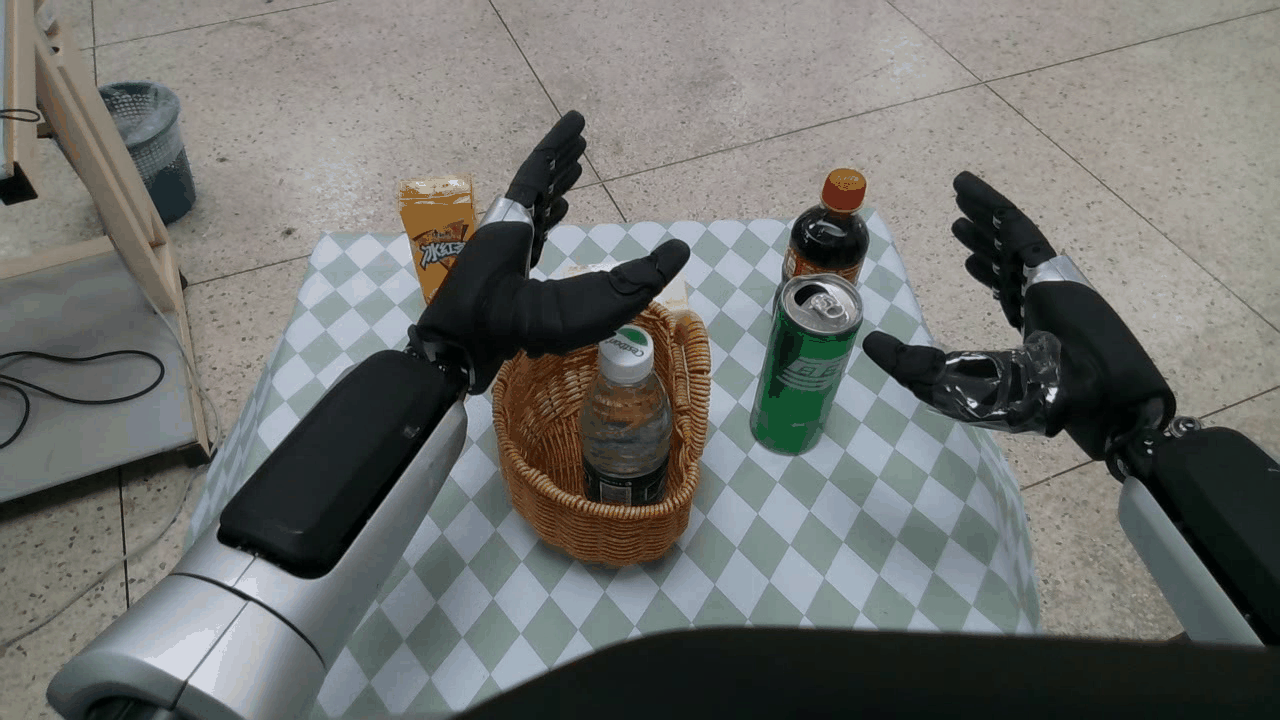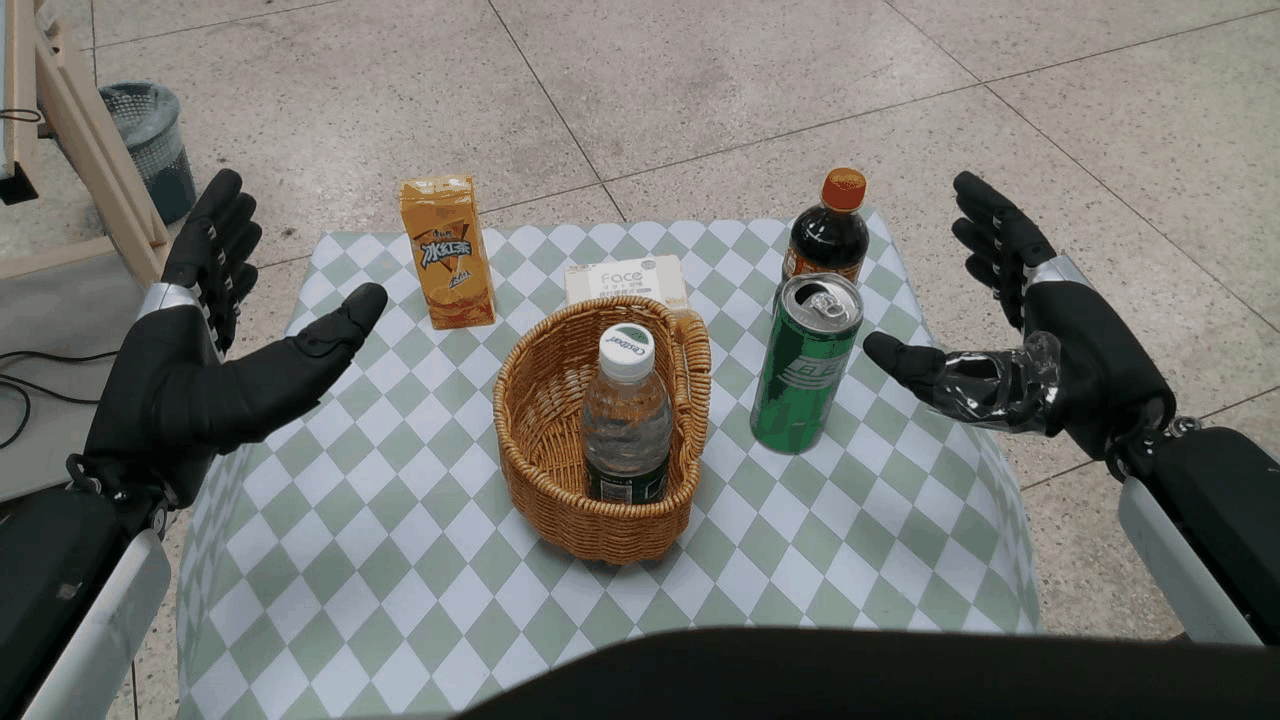
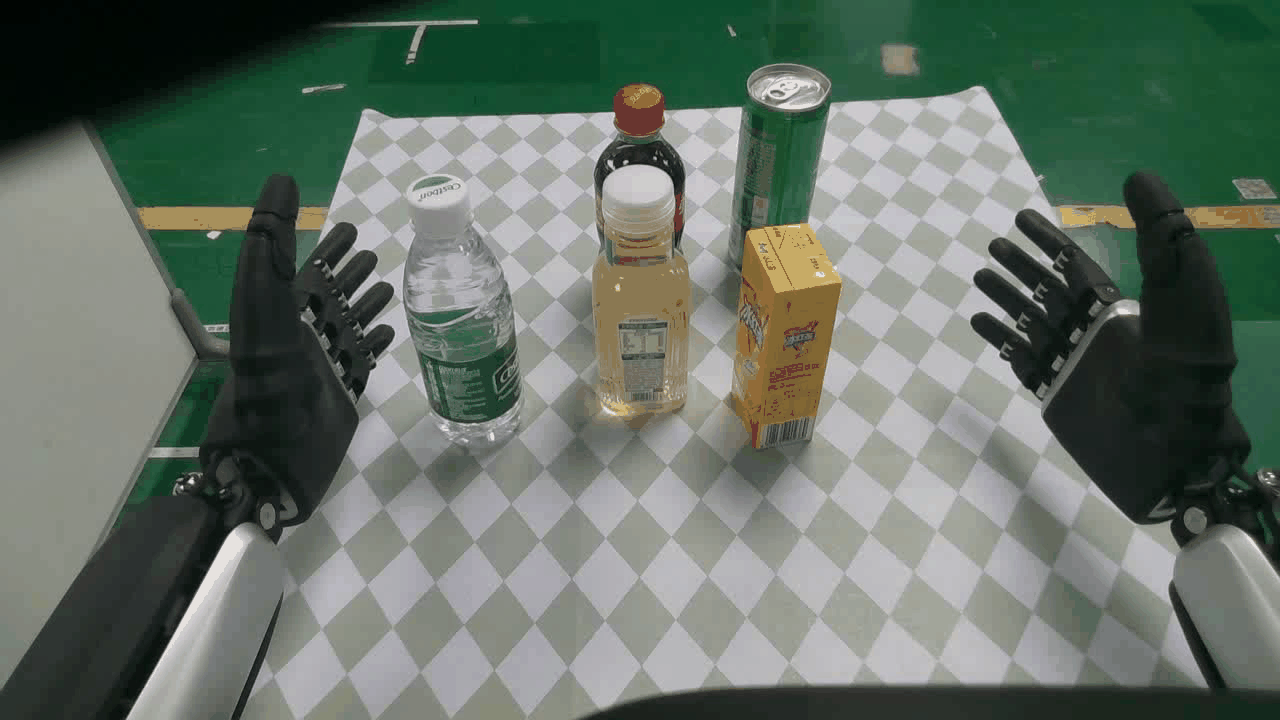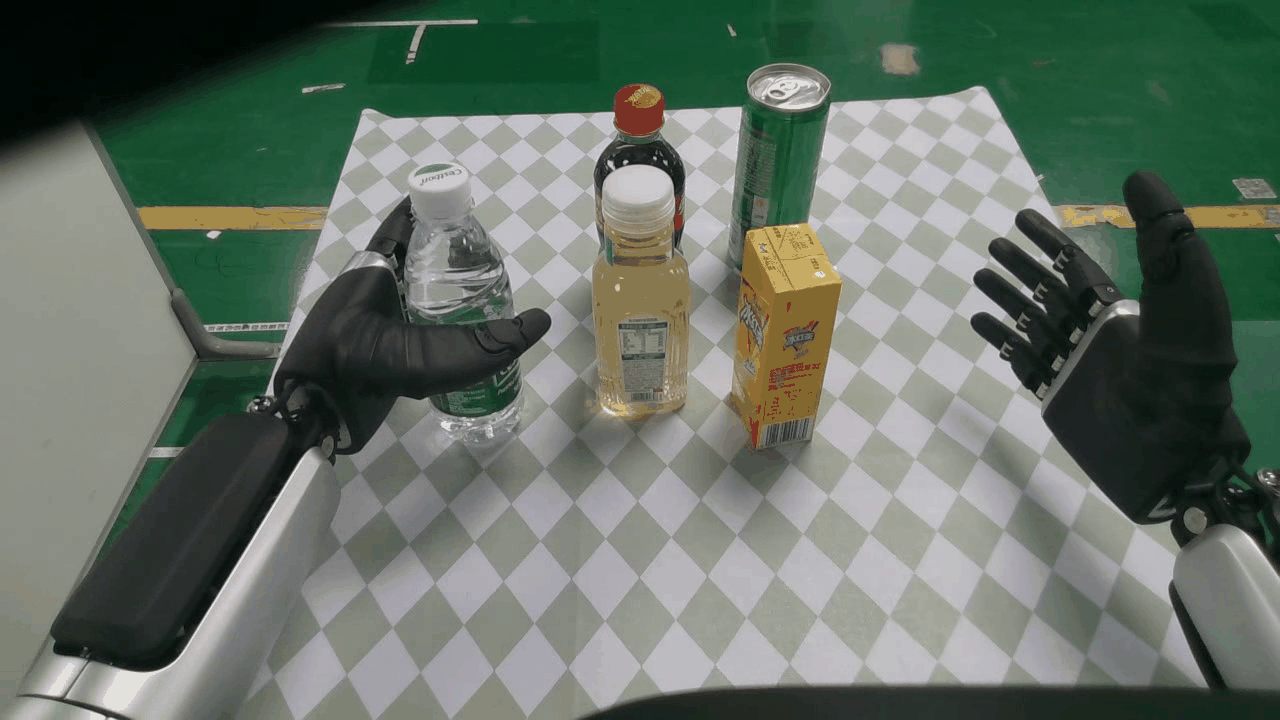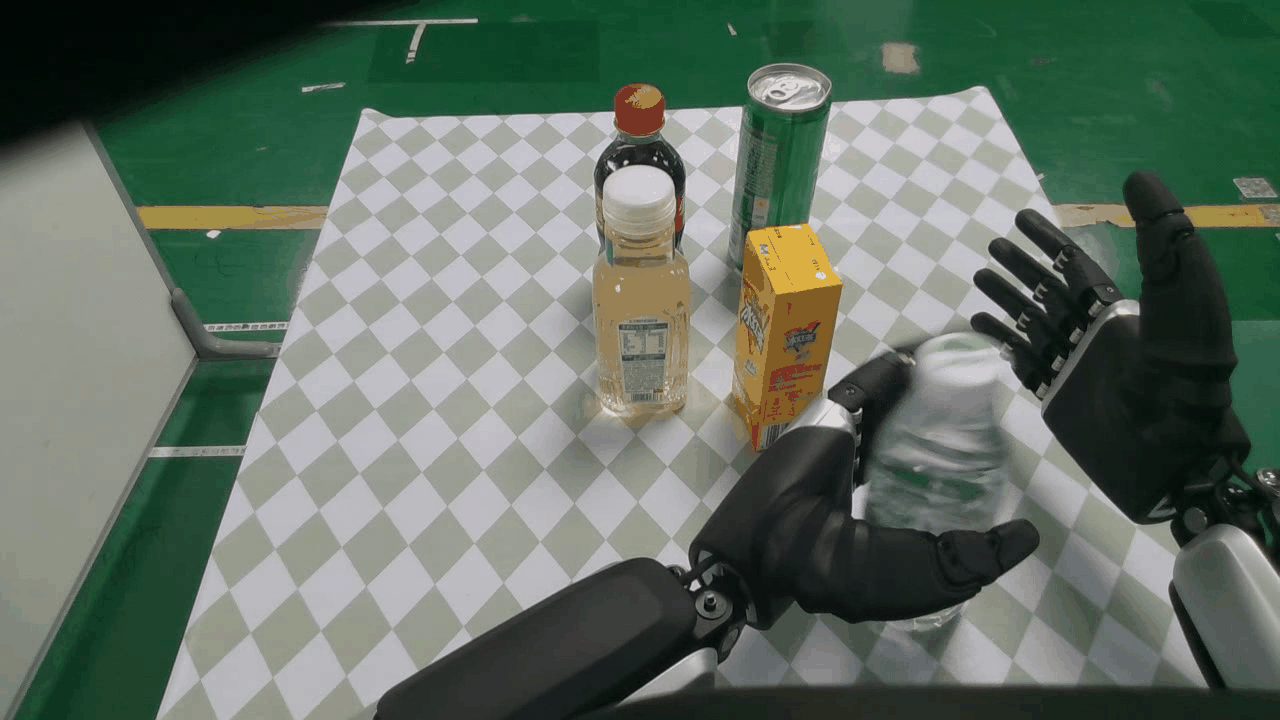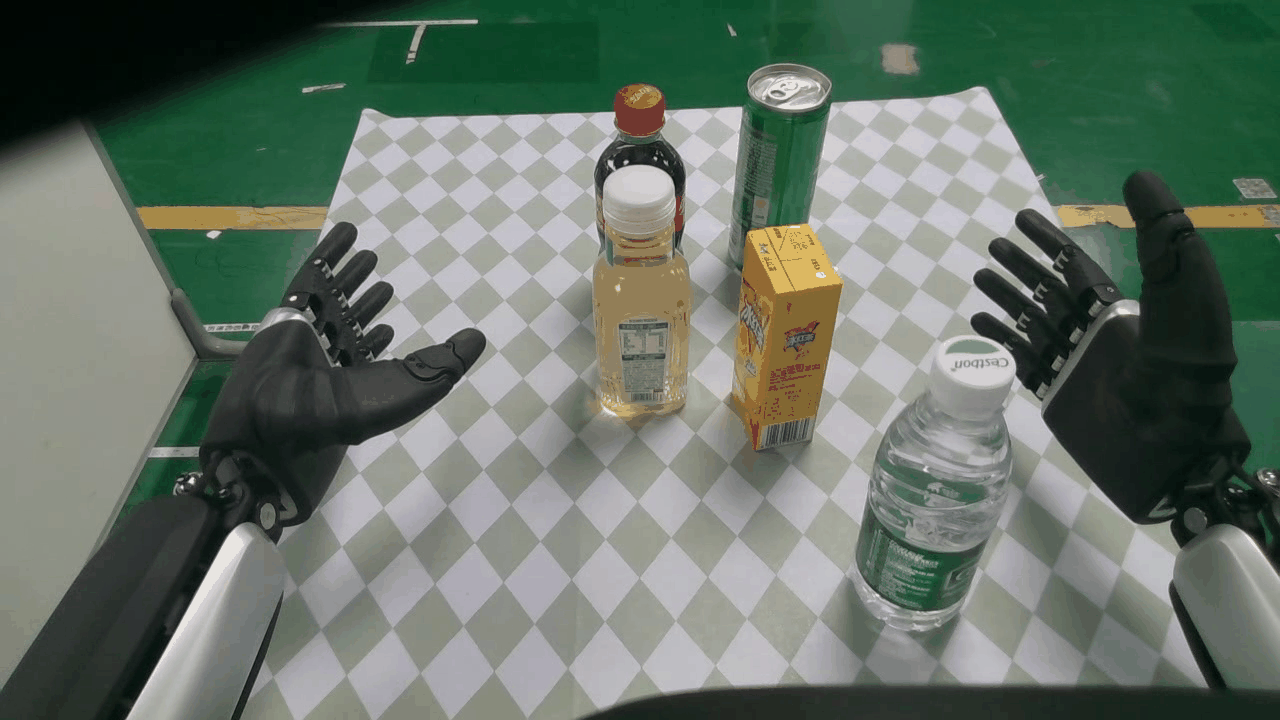
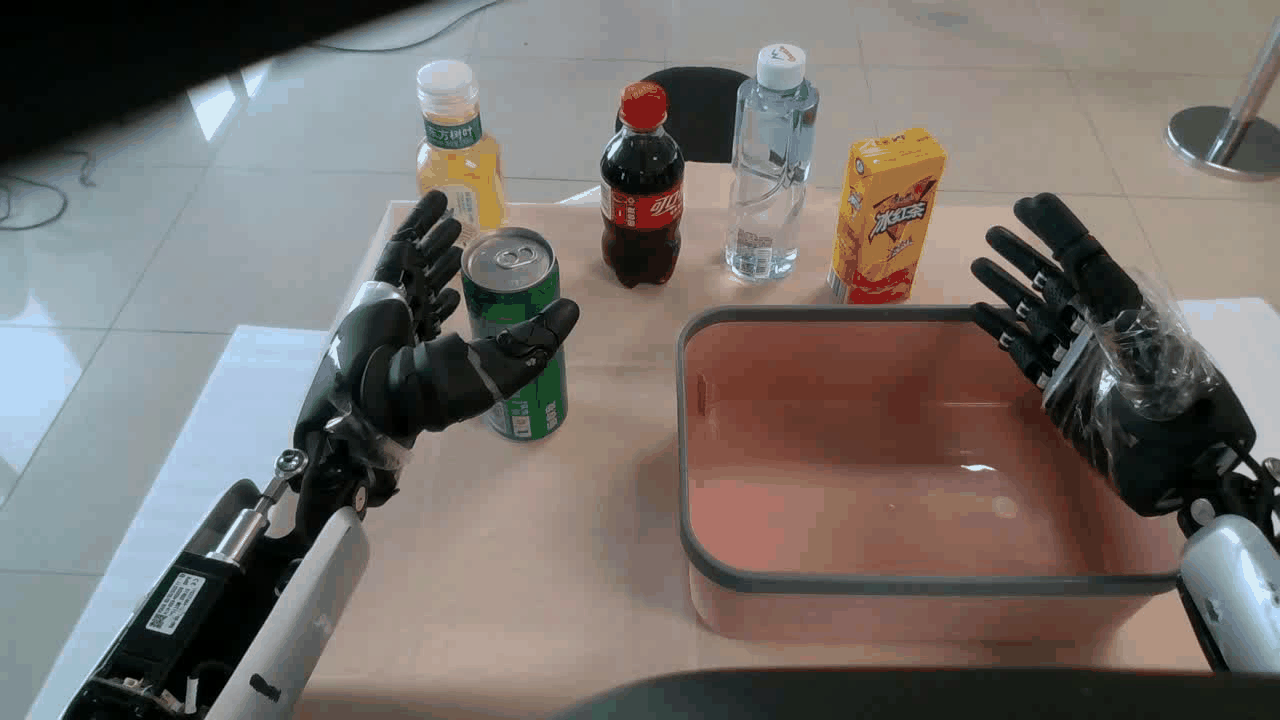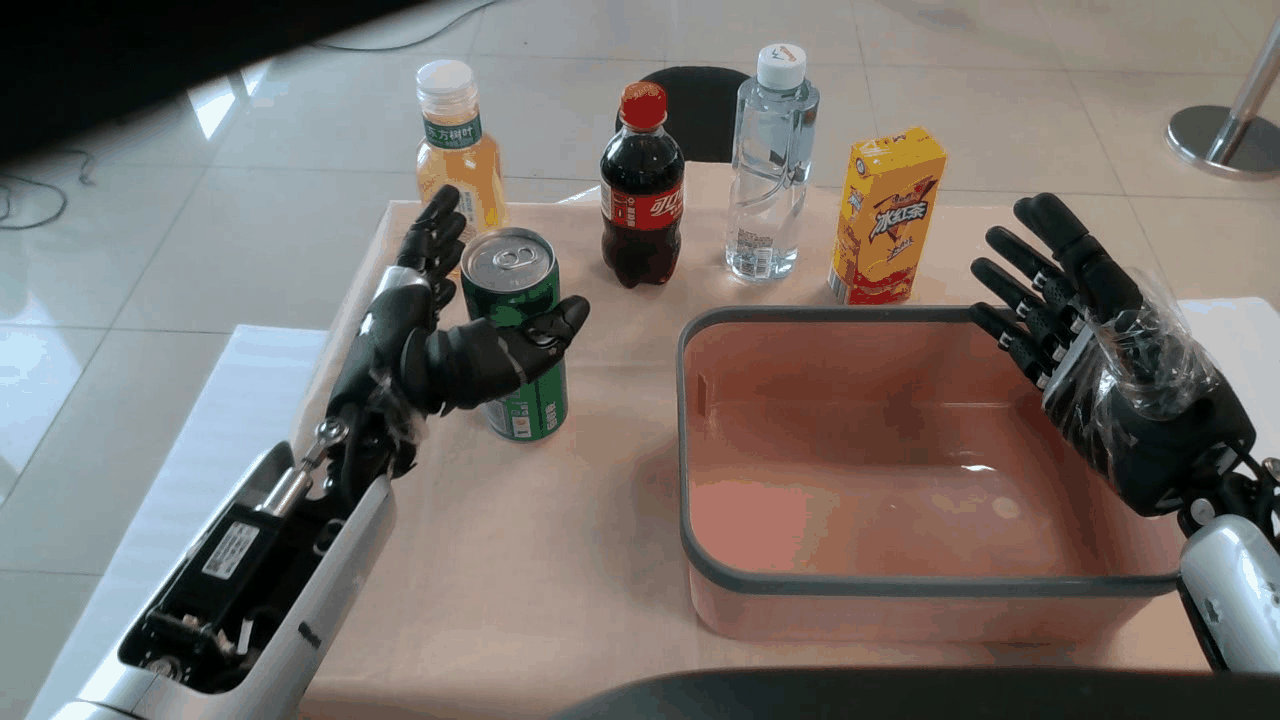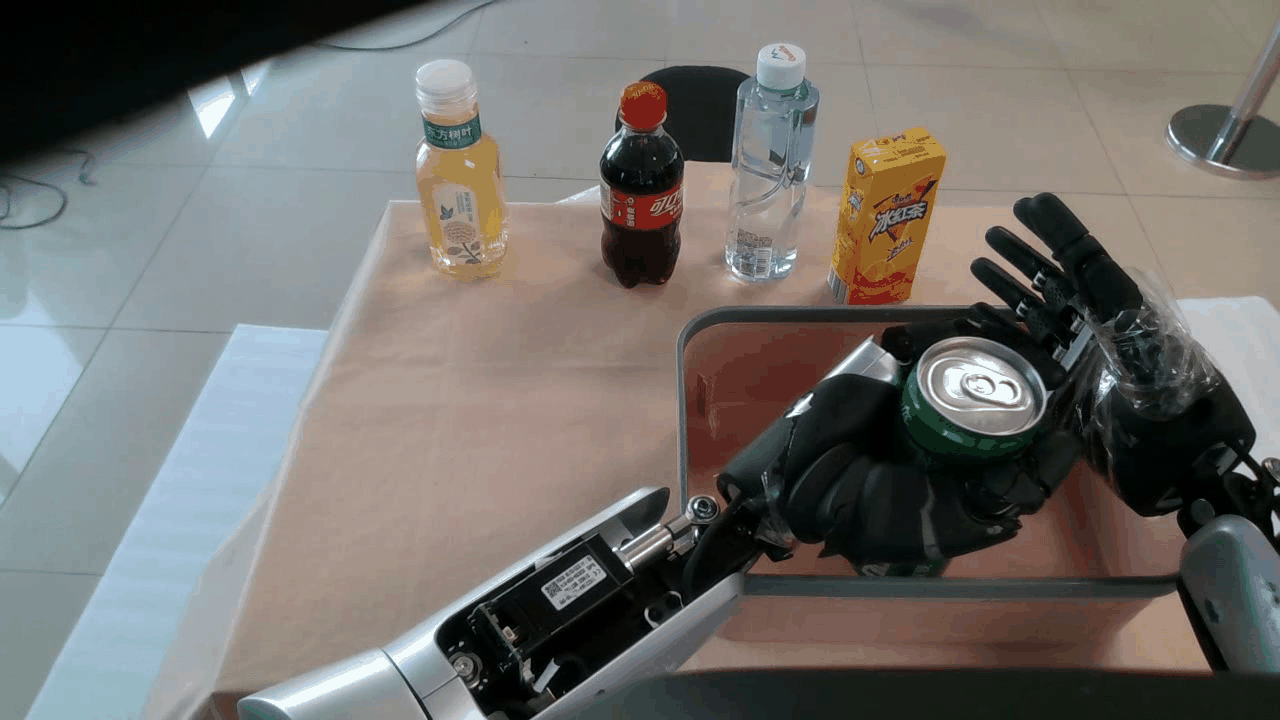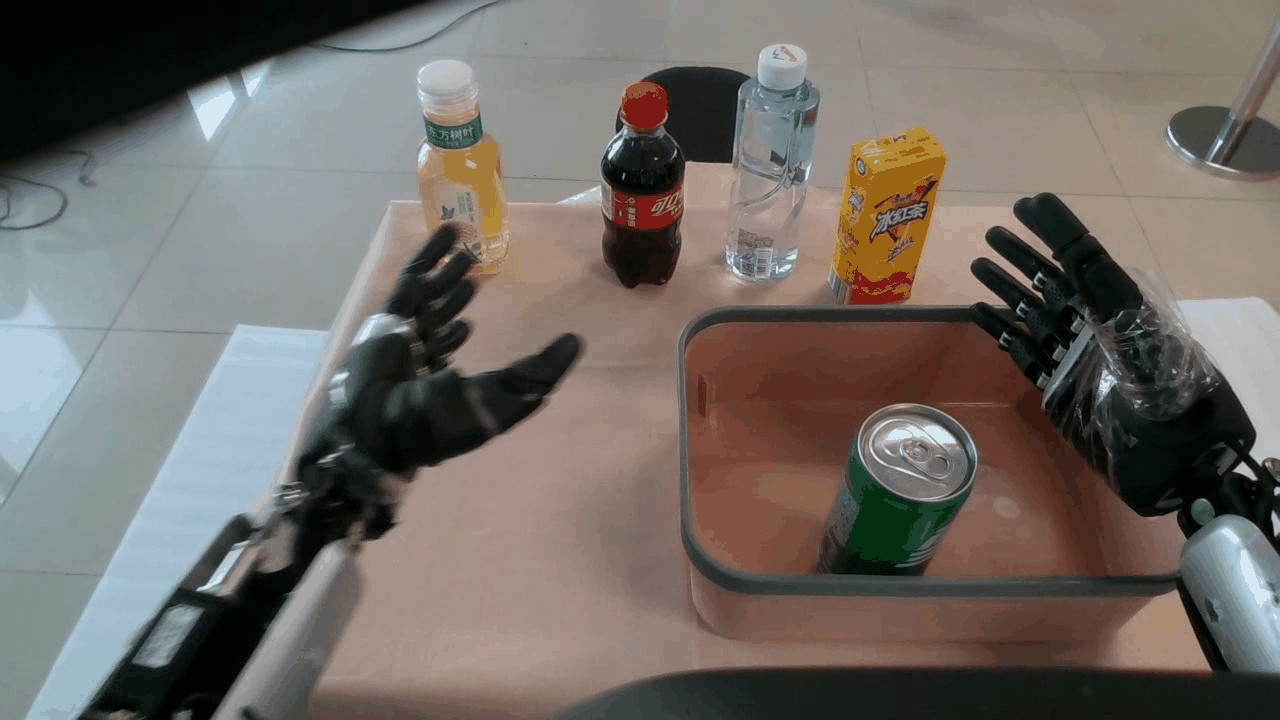
图5 真机任务规划可视化:AgiBot A2 桌面场景下的分步规划与执行
榜单印证:跻身国内第一梯队
方法之后,第三方测评给出了外部验证。SuperCLUE 9月EmbodiedCLUE-VLA测评覆盖国内外10个代表性模型,围绕基础感知、视觉推理、交互与规划、具身安全四大能力展开。中兴通讯Nebula-EmbodiedBrain-180B以77.48分的总成绩,与2.4T参数的Qwen3.8-Max-0902并列国内榜首,跃居具身大脑第一梯队。
在具身安全专项榜单中,Nebula-EmbodiedBrain以97.92分的高分领跑,展现出极高的可靠性与安全性;整体来看,中兴Nebula-EmbodiedBrain-180B以千亿级参数规模,实现了与业界万亿级超大模型的性能对齐。需要说明的是,该榜单中国际参考模型GPT-6 Astra(86.75)、Gemini-3.8-Flash(82.12)作为参考项不参与国内排名,中兴以77.48分位居国内并列第一、全球第一梯队。
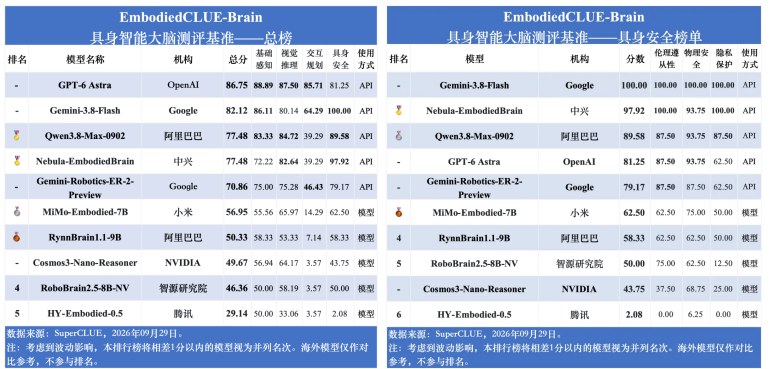
图6 SuperCLUE EmbodiedCLUE-VLA(具身大脑)2026年9月总榜(国际模型为参考项)
从8B专项模型的训练范式突破,到180B级大脑模型的综合能力打榜,这套“以最小成本换取最大能力”的技术路径,正让长程规划从研究走向可复现的行业能力。
从“底层范式”到“上层能力”的完整闭环
从破解长程规划的“连坐”难题,到用极小的样本量跑赢同量级开源模型,再到在第三方权威榜单中与国际巨头并踞第一梯队,这套训练范式在具身智能赛道完成了一次从“底层训练范式”到“上层通用能力”的完整闭环。
先有扎实的方法论打底,再有硬核的榜单成绩背书,这不仅印证了技术路线的先进性与泛化能力,也为行业提供了一套可复现、高性价比的具身大脑研发路径。在具身智能加速向物理世界迈进的下半场,具备“一口气干完一件活”能力的机器人大脑,正为机器人真正走向千行百业注入强劲动能。
参考来源
[1] EmbodiedMind: Adaptive Data Curation and Prefix-Tree Reinforcement Learning for Efficient Embodied Intelligence, arXiv:2609.19659
[2] SuperCLUE 2026年9月 EmbodiedCLUE-VLA(具身大脑)测评榜单