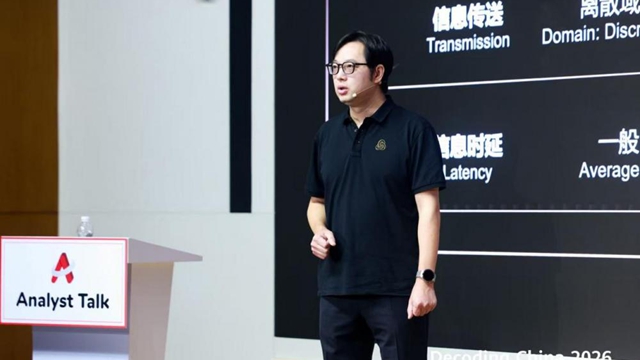





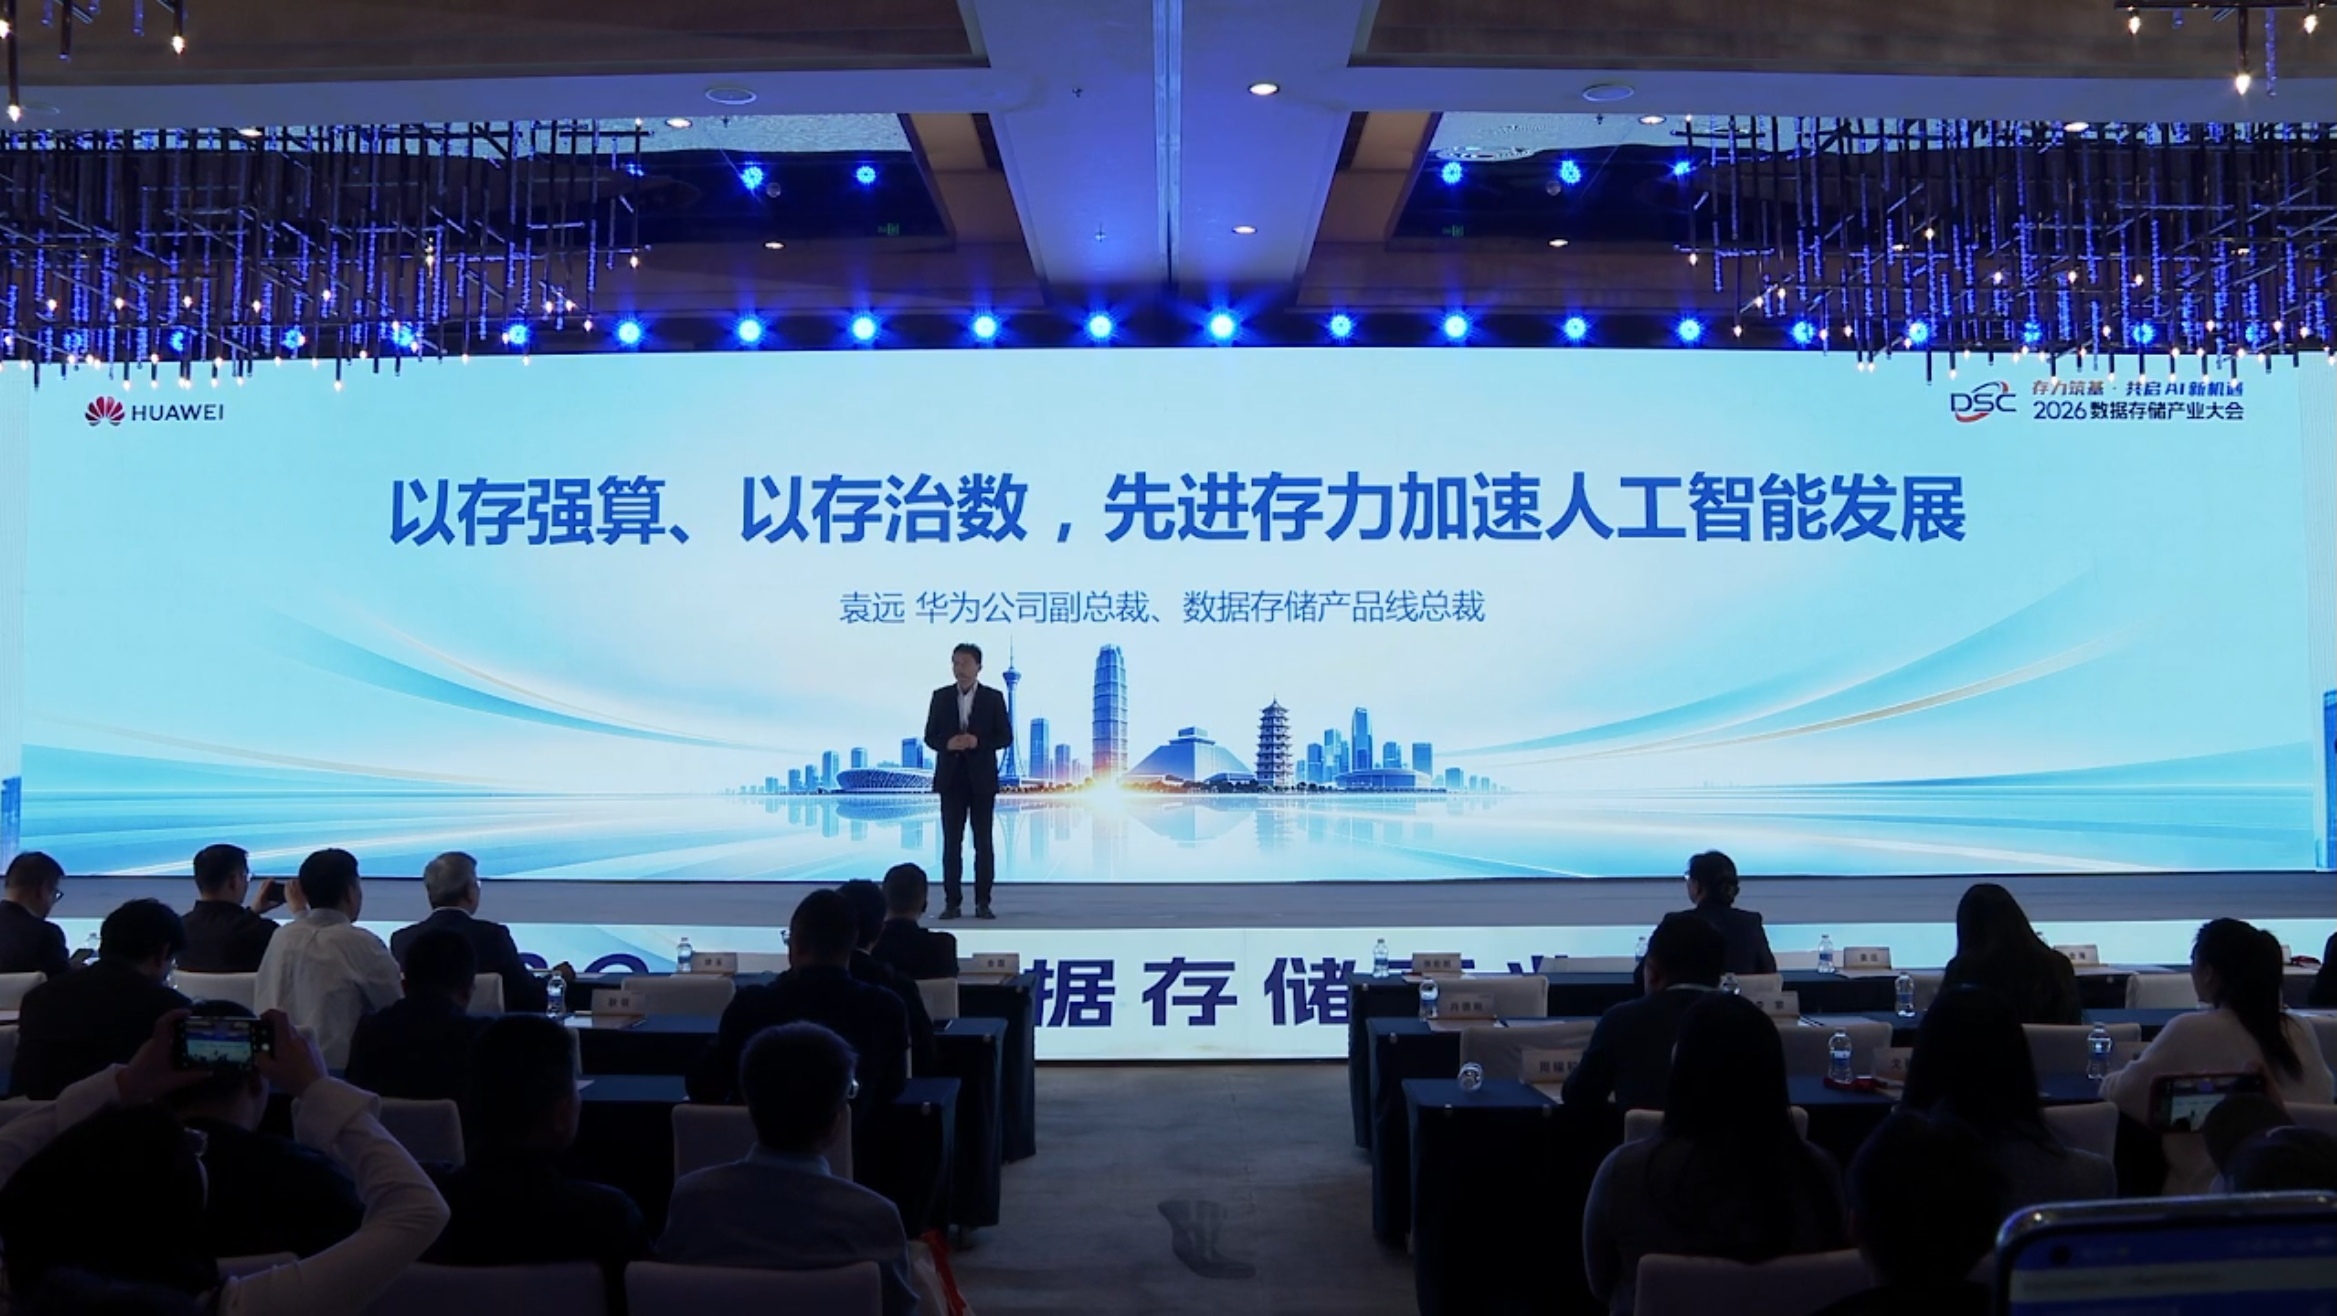
C114讯 10月31日专稿(蒋均牧)10月29日,2026数据存储产业大会在河南郑州举行。华为公司副总裁、数据存储产品线总裁袁远登台发表《以存强算、以存治数,先进数据存力加速人工智能产业发展》主题演讲,系统阐述了对AI时代存储价值的判断与实践。
当下,全球存储产业正处于历史性的拐点。TechInsights《麦克林报告(McClean Report)》2026年6月更新版预计,2026年全球存储器市场规模将增长298%、达9164亿美元,为半导体产业增长最强劲的板块;摩根大通年中亦大幅上调预测,认为2028年全球存储市场总规模将达1.7万亿美元。在我国,工信部、国家发改委于9月份联合印发《电子信息制造业发展“十五五”规划》,首次以独立段落系统规划数据存储产业——存储这门昔日的“幕后行当”,正被推向“国之重器”的位置。
AI高歌猛进的表象之下,两道短板清晰可见。袁远在演讲中引用了一组引人深思的数据:2026年一季度,中国智算中心GPU平均利用率仅约30%,这意味着七成的昂贵算力并未产生实际价值;而在数据侧,2025年全球中文语料占比不足5%,企业真正能触及并使用的数据开发率仅为28.4%。在资源约束与技术封锁的双重压力下,如何把有限的算力用在刀刃上,如何让庞大且粗糙的数据转化为AI可识别的燃料,成为了一个必须跨越的门槛。他给出的解题思路,正是围绕“以存强算”和“以存治数”展开的双向发力——AI时代的存储已超越传统硬件的范畴,成为串联起AI使用端与生产端的坚实底座。
以存强算:让算力不再“空转”
各地智算中心竞相上马、GPU一卡难求,算力焦虑的背面,实则是七成算力被闲置的惊人浪费。补利用率之课,某种程度上比补算力之课更紧迫。
存储能做些什么?袁远沿智能体、推理、训练三条线索展开。智能体层面,Agent以自我演进方式运行,算力消耗极其密集,还持续产生海量中间数据,存储的价值在于充当算力的“节流阀”,减少无效消耗、提升有效产出、摊薄Token成本。推理层面效果更直接,大模型推理依靠KV Cache在算力卡之间传递信息,这种交换代价高昂——高带宽低时延网络技术我国尚未完全掌握,HBM内存每GB售价约20美元。破题之法是把持久性强、变动小的数据从昂贵内存中“搬下来”存好,需要时直接调取,免去重复计算,“就像我们小时候背九九乘法表,每个人都知道九九八十一,没必要每次再计算一遍”。训练层面,矛盾指向集群可用度,2027年模型参数有望摸到10万亿级,超大集群“动不动就坏”,一天24小时有效训练时间可能只有两三个小时。存储的作用是把Checkpoint保存与恢复时间压到最短,让模型能弹性回归上一状态,同时把自身可靠性做到极致,避免训练成果因存储故障前功尽弃。
由智能体而推理而训练,存储在每个环节都是算力效率的放大器,早已超越“仓库”的旧定位。以存强算的实质,是以体系化的数据供给能力,填平标称算力与有效算力之间的鸿沟。这笔账算下来,存储的性价比未必输给GPU。
以存治数:把“沉睡”数据化为AI竞争力
数据决定模型的高度,同样决定推理的准确度。如果缺乏高质量的行业数据喂养,AI即便能作诗,也难以真正办事。袁远在演讲中直言,我国庞大的行业数据目前多处于“不可用”状态,数据开发率不足三成的现实,暴露了数据工程能力的滞后。他近两年走访国家重点实验室和行业头部企业,发现大家都有归集数据、形成知识的宏大构想,落到实地却普遍举步维艰。
从原始数据到AI可用资产,需要穿越语料、知识与记忆三个层面。其中,语料是起点,行业原始数据不经标记、清洗、转换,AI便无从消受,语料库还须建统一目录和索引,可管可查。知识是进阶,医疗专家、科学家头脑里沉淀的经验,连同实验数据,要转化为高维、可检索、AI可识别的知识化数据,还得统一标准,否则同一份数据在不同行业各说各话。记忆关乎智能体的本质,Agent与既往工具软件最大的区别是自我演进,演进的前提是记住来路——如同人从跌倒处学会绕行,机器也需要记忆轨迹管理系统。
“积学以储宝,酌理以富才”。为学如此,为AI亦然——数据不经“储”与“酌”,散落的字节永远成不了珍宝;语料库、知识湖、记忆库的建设,恰是AI时代“积学储宝”的基本功。数据决定模型的高度,也决定推理的准确度;幻觉丛生的模型,“只能做诗,不能做事”。治数是慢功夫,更是硬功夫。
All in One与One for All:架构适配场景,生态标准致远
思路厘清之后,问题回到产业如何落地。华为的答案是分场景施策:AI的使用端与生产端需求迥异,架构理应分道而行。
金融、医疗、科研等国计民生行业属于AI使用端,不训练基础模型,也不对外提供AI服务,要的是一个简单省心的数据底座。为此,华为推出All in One架构的AI数据平台:延续企业IT“一套系统配一套存储”的熟稔模式,一套存储同时承载数据留存、KV Cache加速、知识生成、语料管理与Agent记忆,内置图、向量、搜索能力,避免多套系统并存带来的新割裂。这套架构已迭代一年,开始在部分行业落地。
AI生产端则是另一幅图景。模型厂商、互联网企业以十万级服务器规模运转,需要One for All式的专属系统——900PB单文件系统,千亿级向量库秒级检索,TB级聚合带宽,液冷环境下的10PB级KV Cache。这些“看起来怪头怪脑”的大家伙,瞄准AI生产的效率与成本,落脚点是让AI服务惠及更多人。
单点的产品走不远,产业的事还要产业一起做。袁远在演讲结尾发出倡议:建立从存力到AI价值的评估体系,让“存很重要”从道理变成可量化的数字;围绕记忆、知识等新应用共建生态,避免各家重复投入;以本次大会发布的团体标准为起点,推动更多企标、国标成形,把AI工具链、接口与管理方法固化下来。“就像今天银行需要数据库和存储已成约定俗成,将来Agent需要AI数据平台,也会成为标准配置。”
存储产业的竞争,本质上已上升为产业生态主导权与标准定义权的较量。正如本次大会发布的《数据存储产业发展研究报告(2026版)》所揭示的,中国存储正从“技术突破”迈向“市场地位确立”。从“建湖”走向“用湖”,从硬件交付走向STaaS服务,产业的每一次跃迁都呼唤更为坚实的存力底座。华为通过“以存强算、以存治数”的路径探索,不仅为AI产业的加速落地提供了一套可执行的工程蓝图,也为中国存储产业在全球竞争中确立自身坐标,提供了一份兼具战略视野与战术颗粒度的时代注脚。