




2026年9月19日,华为全联接大会2026“携手业界主流开源社区,解锁昇腾创新新动能”专题论坛在上海圆满举行。本次论坛汇聚了Linux基金会、PyTorch基金会、vLLM社区、郑州先进实验室、魔搭社区以及Ascend for PyTorch社区优秀开发者等多方社区专家,共同探讨在AI Agent时代,如何通过开源协作、软硬协同及训练范式演进,构建开放、可持续的AI产业生态。
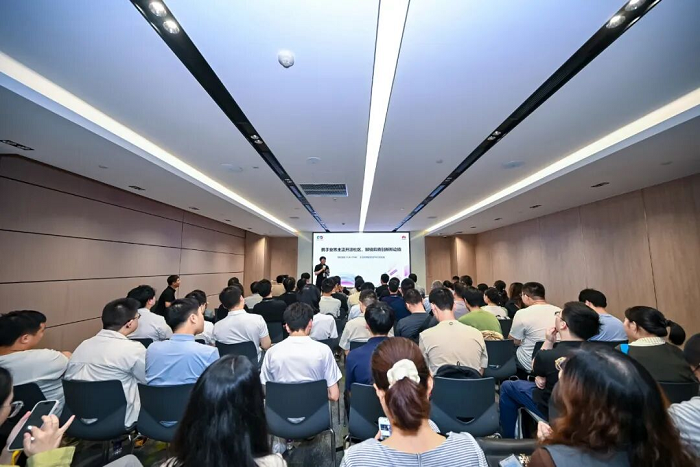
现场照片
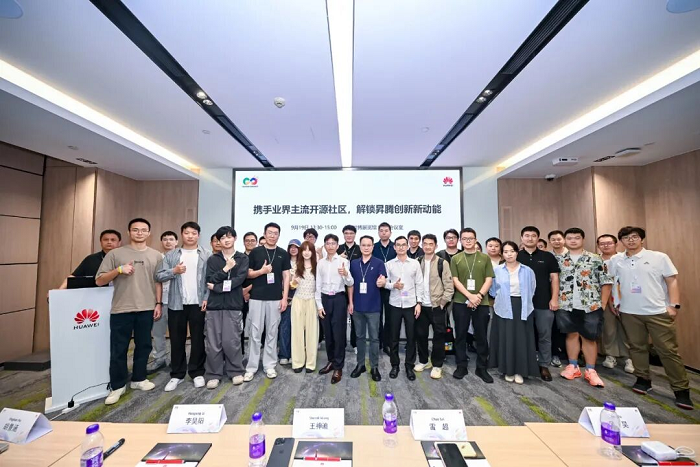
现场照片
昇腾携手PyTorch开源共建,开拓AI生态新时代
华为昇腾AI框架生态负责人王神迪在演讲中表示,AI模型持续突破规模与复杂度边界,AI生态面临新挑战,昇腾深耕AI产业八年,已建成中国最具活跃度和影响力的开放AI产业生态。自2020年昇腾与PyTorch合作起步,到今年7月PyTorch官网正式上线Ascend NPU,成为官方支持首个中国硬件以及9月9日PyTorch Conference China 2026峰会联合基金会的超节点Live Demo首秀,都标志着昇腾正全面融入PyTorch官方原生生态。目前,昇腾正通过重构百万测试用例、接入官方CI/CD体系等,与PyTorch从适配对接迈向生态共建。其中CICD系统已实现上游PR可见昇腾CI结果,成为首个达成社区CI系统L3标准的中国硬件。Ascend for PyTorch社区自26年5月成立以来,已汇集社区一千多位核心开发者,外部PR占比超过50%,成为中国发展最快的AI社区,同时社区还推出了一系列课程、开源项目及社区任务,提供多种激励模式和在线算力资源,呼吁广大开发者可以一起参与开源共建。
华为昇腾AI框架生态负责人 王神迪
开放系统加速AI演进,共建统一AI框架生态
Linux基金会中国区总监、PyTorch 基金会亚洲区总监 李昊阳进行了《OPEN SYSTEMS LEARN FASTER》议题分享。演讲指出,当前AI时代从硬件、基础设施到训练推理及Agent层,均有重要开源技术支撑,国内AI硬件虽呈现百花齐放的多样化态势,但若软件栈各自为战将导致严重碎片化,因此需要开放系统促进开发者协作共建统一工作流。同时强调,模型、框架与硬件相互牵动,形成持续演进的循环,开放系统能让金融、电信等不同领域共享反馈、协同迭代。PyTorch基金会采用Ecosystem到Hosted的两级孵化体系,现已托管vLLM、DeepSeep、Ray等项目,并且由昇腾团队主导的Accelerator Integration Working Group,正在推动“PyTorch跑在任何云、任何加速器上”的战略。PyTorch 2.14发布、昇腾CI达到L3水平等,均是开放协作的成果。
Linux基金会中国区总监、PyTorch 基金会亚洲区总监 李昊阳
vLLM Ascend突破长序列KV Cache存储瓶颈
vllm-ascend Maintainer 雷超分享了《KVPool与DSA KV Offload在vLLM Ascend中的进展与规划》议题。在KVpool方面,面对混合注意力、混合架构带来的缓存语义异构与前缀缓存规则不统一等挑战,实现了Multi KV Group支持,存储上支持SSD卸载,传输上支持超平面内存语义,链路更短、带宽更大,优化Layerwise后,在GLM-5.2 TP16上使TTFT降低21%-30%。在DSA KV Offload方面,针对长序列下片上内存容量不足的问题,长期选择KV Offload方案,使用冷KV卸载至CPU DRAM、异步加载、叠加两层Overlap等技术,吞吐达DCP方案的2.8至3.8倍。未来将持续优化Layerwise、构建跨超节点的大规模内存池、开发融合算子,并与vLLM社区探索动态方案。
vllm-ascend Maintainer 雷超
基于AscendNPU IR打造ACAGEMMs算子自动生成系统
郑州先进实验室-编译实验室技术部部长 吴昊 在《ACAGEMMs:基于AscendNPU IR的算子自动生成 》介绍了ACAGEMMs算子自动生成系统。议题指出,大模型生成Kernel只是起点,真正交付还需经过编译、正确性验证、性能优化与泛化测试。
ACAGEMMs系统以涵盖语义、输入域、边界条件、验收标准和运行环境的任务契约贯穿生成、验证、测量与交付全过程,依托候选树、证据链、经验树三大机制管理搜索、验证与经验复用,并设置编译、正确性、性能三层Gate对候选做静态预检与归因筛选,失败证据反向约束下一轮搜索,避免浪费真机资源。在昇腾A2上的测试表明,该系统能有效筛选高质量候选,加速比达1.42,Token消耗降低55%。团队作为FlagGEMS等项目的核心贡献者,致力于通过开源分享降低算子开发门槛,推动编译器技术进步。
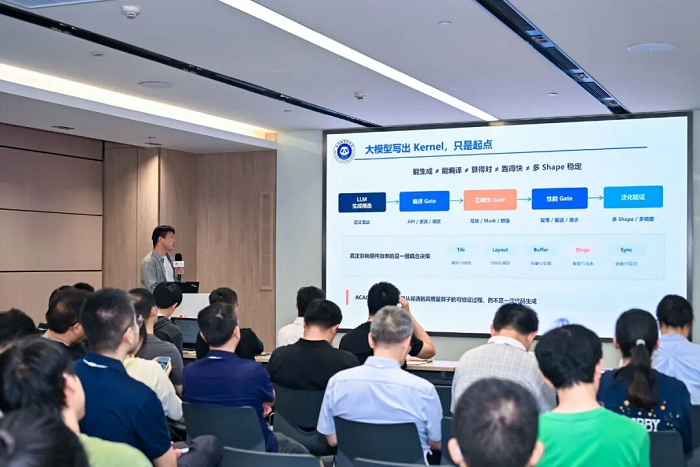
郑州先进实验室-编译实验室技术部部长 吴昊
从预训练到训练服务化,ms-swift、Tinker助力高效训练
魔搭社区技术专家 胡景涵发表《模型训练范式:从微调到自进化和训练服务化》演讲,首先回顾大模型训练技术从2018年BERT/GPT开启预训练时代一直到2026年自进化训练兴起的演进历程,随后指出开发者仍需训练模型,原因包括私有领域知识注入、行为可控性与安全对齐、大模型能力蒸馏到小模型、基模知识持续更新。为降低训练门槛,魔搭社区推出ms-swift框架,覆盖训练、推理、评估与量化部署,支持多种模型与算法;并提出服务化训练框架Tinker,开发者无需本地显卡即可远端训练。社区还提供NPU支持文档与镜像,并持续进行框架底层重构,欢迎开发者共建。
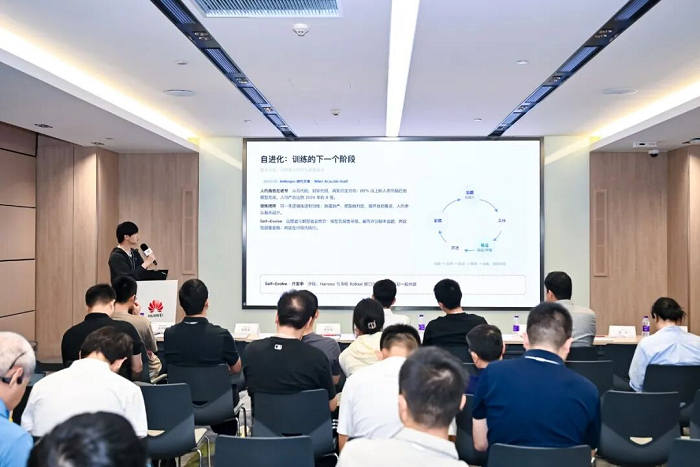
魔搭社区技术专家 胡景涵
Ascend for PyTorch的开发之旅,从代码使用者变为上游贡献者
Ascend for PyTorch社区开发者 王贝琦在《从“支持”到“共建”:我的Ascend × PyTorch开源实践》议题中分享了参与昇腾社区贡献的经历与心得。通过PyTorch原生API的NPU验证工作和上游社区测试用例解耦任务体会到“能跑通只是起点”,真正的目标是行为与生态完全对齐,共建NPU生态并非为NPU添加特殊分支,而是帮助上游实现特性设备无关。议题中将“从支持到共建”总结为四步:代码跑通、在NPU上正确运行、API测试与文档生态完全对齐、将通用能力回馈上游。开发者可以从小处着手,一个API、一条测试、一个Issue或PR都能成为开源协作的起点,从代码使用者变为上游贡献者。
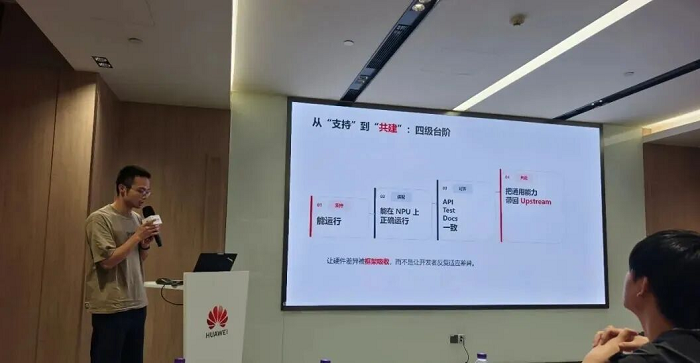
Ascend for PyTorch社区开发者 王贝琦
本次论坛充分展示了昇腾与开源社区紧密合作的成果,以及各方在AI基础设施、框架生态、推理优化及训练范式上的最新进展。面向未来,昇腾与业界开源社区持续深入协作,共建AI产业繁荣开放新生态。